

[译] 一种面向时空可组合性的编程范式
一种面向时空可组合性的编程范式
GitHubcordiverse/paper本文是论文《A Programming Paradigm for Spatiotemporal Composability》的中文技术译稿,供学习与研究参考。
译文保留了原文的数学符号、定义/定理/算法编号、代码标识符及参考文献编号;常用技术术语在首次出现时附英文括注。
本译文为非官方翻译,不代表原作者或原项目立场。阅读关键技术细节时,请以英文原文为准。
原文仓库:
原文 PDF:paper.pdf
译者:Mint
Yifan Shi1,2,Wei Zhang1,Tianyi Cui2
1北京大学 2DeepSeek-AI
技术中文译稿。数学符号、定义/定理/算法编号、代码标识符及参考文献编号均沿用原文;常用技术名词在首次出现或术语说明处补英文括注,例如 智能体(agent)、智能体运行框架(agent harness)、插件(plugin)、组件(component)、依赖(dependency)、运行时(runtime)、编排器(orchestrator)、提供者(provider)、消费者(consumer)。为避免术语歧义,
effect译为“效应(effect)”,coeffect译为“余效应(coeffect)”,context译为“上下文(context)”,fiber译为“纤程(fiber)”。
摘要
从插件(plugin)系统到可自我演化的智能体运行框架(agent harness),现代软件日益需要动态组合(dynamic composition)能力,但与之相应的形式化基础仍不充分。我们识别出该问题两个彼此正交的维度:时间可组合性(temporal composability),即当一个组件被移除时,能够彻底撤销其副作用;以及空间可组合性(spatial composability),即能够声明并以反应式方式管理组件间依赖。我们将经典的效应和余效应概念提升为运行时(runtime)机制,从而处理这两个维度。具体而言,我们形式化了可逆效应(revertible effect):每次上下文变换均携带一个由运行时追踪的逆变换;我们还形式化了反应式余效应(reactive coeffect):上下文的每一次改变,都会依据组件的余效应规约通知该组件。我们将效应上下文和余效应上下文统一为单一上下文类型,由此构成一种编程范式。随后,我们将这些机制结合为组件(component)的概念,并给出动态组合的演算;其元理论将单个组件的时空可组合性推广到由交错执行组件构成的整个系统。我们在 Cordis 中实现了这些思想。Cordis 是一个支持时空可组合性的元框架,提供具备效应追踪和余效应解析能力的核心库,以及支持配置协调和热模块替换(hot module replacement, HMR)的声明式组件加载器。
1. 引言
组合,即由较简单部件组装复杂系统,是软件工程的一项基础原则 [1]。传统上,组合是静态的:函数调用、模块导入和类继承在编译期解析,并在整个执行期间保持不变。然而,现代软件越来越需要动态组合,即在运行时加载、卸载(unload)和重新配置组件。插件架构 [2] 和可自我演化的智能体运行框架都要求系统能够安全地即时增添和移除功能;但当前实践通常依赖粗粒度机制 [3],只能通过重启来重新配置,并因此丢弃运行时状态。尽管动态组合在实践中的重要性日益提高,相比静态组合所拥有的丰富形式化框架,其理论基础仍不充分。
1.1. 可组合性的维度
为刻画动态组合的要求,除已被充分研究的组合代数性质外,我们识别出两个彼此正交的维度:
- 时间可组合性处理时间维度:移除组件时,该组件对共享环境所做的修改必须被完整且安全地逆转。这要求追踪组件执行的每一次资源分配、事件注册和状态变更,并保证在移除时有序回收它们。
- 空间可组合性处理空间维度:组件必须能够以结构化、可验证的方式声明、发现并解析彼此之间的依赖。这要求管理依赖拓扑,并在依赖发生变化时协同组件的生命周期。
在静态场景中,时间可组合性可归约为词法作用域(例如 RAII [4] 与 bracket 模式 [5]),空间可组合性可归约为模块导入解析 [6]。在组件会于运行时到达和离开的动态场景中,二者都显著更难:时间可组合性必须处理作用域不受词法边界限制的长生命周期、有状态效应;空间可组合性则必须处理在执行期间出现、消失或改变身份的依赖。
1.2. 动机示例
1.2.1. 插件系统
插件系统是动态组合的典型实例。我们以最广泛使用的可扩展 IDE 之一 Visual Studio Code(VSCode)作为代表性示例。
**时间维度的局限。**VSCode 在称为 extension host 的共享进程中运行全部扩展。虽然扩展可以动态安装,但该宿主并未提供在运行时卸载单个扩展代码的机制。一旦扩展的 activate 函数已经执行,禁用或卸载该扩展就必须重启整个宿主,从而影响所有已加载扩展。主题、键绑定和代码片段等纯声明式扩展不含代码,因而可以自由移除;但按安装量排名的前 100 个扩展中,有 87 个包含可执行代码1,移除时便需要这样的重启。尽管 VSCode 提供了 deactivate 钩子(hook),它仅作为宿主进程终止时的优雅关闭回调,因此不能实现在线移除。此外,该钩子将效应的释放与效应的创建(发生在 activate 中)分离,违反了关注点局部性,使完整清理难以验证。
**空间维度的局限。**VSCode 确实通过 extensionDependencies 支持声明扩展之间的依赖,但这一机制鲜少使用:按安装量排名的前 100 个扩展中,仅有 7 个对非内置扩展声明了 extensionDependencies。1 这一稀缺性反映了扩展 API 的形态:它暴露的是命令、视图和语言功能等固定的表层扩展点。扩展经由这些扩展点向宿主贡献能力,而非相互依赖,因此扩展间依赖很少出现。更重要的是,VSCode 的扩展间交互机制没有提供结构性契约:一个扩展通过 vscode.extensions.getExtension(...).exports 向其他扩展暴露功能,但返回值默认是无类型的 any,依赖方因而无法依赖经过检查的接口。简言之,VSCode 引导扩展面向一组固定的、由宿主提供的扩展点进行开发,却没有提供让扩展彼此安全、结构化地依赖的方式。
这两个局限并非 VSCode 独有;它们以程度不同的形式普遍存在于插件系统中 [2, 7]。
1.2.2. 可自我演化的智能体运行框架
现代 AI 智能体依赖运行时智能体运行框架 [8–10]。这些系统可以组合多样的工具套件 [11] 与执行环境,管理权限和沙箱(sandbox),维护会话状态与持久化,提供上下文管理和记忆系统 [12],编排子智能体及多智能体工作流 [13],并向用户和自动化系统公开接口。未来的智能体运行框架可能会在持续处理请求的同时,生成并部署对自身组件的修改。由模型合成的可复用工具是组件级自修改的一个较窄前身 [14];每一次此类修改本身都是动态组合的实例。
由于这些修改持续发生,且人工监督有限甚至不存在,动态可组合性因而不可或缺。没有时间可组合性,每一次自修改都会迫使系统完全重启,丢弃所有进程本地累积状态;在如此频繁的修改下,累积不可用时间将十分可观,执行中的任务也会反复中断。更糟的是,错误的自修改可能禁用恰恰用于恢复的进程。没有空间可组合性,每个模块都必须自行检测并适配它依赖模块的出现、消失或身份变化,并且只能以临时拼凑的方式完成;更糟的是,朴素的代码替换策略可能悄然破坏依赖方,或引入只有在重新加载时才显现的循环依赖。
1.2.3. 粗粒度的替代方案
动态可组合性之所以获得的形式化关注有限,一个原因是操作系统和容器编排器已经提供了粗粒度替代方案。操作系统在进程粒度上提供时间可组合性;容器编排器 [3] 则在服务粒度上提供空间可组合性。实践中,大多数软件通过诉诸这些粗粒度机制来容忍缺乏细粒度可组合性的事实:行为异常的模块通过重启进程处理,服务依赖则交由容器编排器管理。
然而,这一替代方案代价高昂。就时间而言,每次重启都会丢弃所有进程本地的累积状态(如缓存、连接和部分计算结果),重建它们需要数秒至数分钟 [15];为在此期间维持可用性,系统必须部署冗余副本,以资源开销补偿无法恢复单个组件的缺陷。就空间而言,容器级编排无法表达共享同一地址空间的组件之间的依赖,并会为本可通过本地函数调用完成的交互引入网络开销。两种机制都工作在进程和容器边界上,而现代系统的组合正日益发生在更细的层次。这种粒度失配要求一种组合抽象:它应当在与组件自身相同的层次上管理效应与依赖。
1.3. 贡献
动态可组合性的两个维度分别关涉计算如何修改环境,以及计算如何依赖环境。这两个方向正是效应系统 [16, 17] 和余效应系统 [18, 19] 所形式化的内容:效应提供推理环境修改的形式化词汇,余效应提供推理环境需求的形式化词汇。然而,现有表述将推理限制在词法范围固定的编译期分析中,不能扩展到组件于运行时到达和离开的动态情形。通过将效应提升为可逆的运行时模型、将余效应提升为反应式依赖解析机制,我们得到一个统一的动态可组合性形式化基础。该基础与语言无关,适用于任何需要动态组合的软件架构。本文贡献如下:
- 形式化可逆效应(第 3.1 节):每个上下文变换都携带由运行时追踪的显式逆变换;追踪和恢复均保持组合性,因此组件移除时可恢复上下文。这建立了局部时间可组合性。
- 形式化反应式余效应(第 3.2 节):组件以规约形式声明其所需余效应;上下文的每次改变都会依据该规约将组件通知为激活、停用或中性状态。这建立了局部空间可组合性。
- 将效应上下文与余效应上下文统一为单一上下文类型(第 3.3 节)。在该类型中,余效应上的观测等价关系为效应提供独立性,从而构成一种面向时空可组合性的编程范式。
- 给出动态组合演算(第 4 节):该演算将两种机制结合为组件概念,并以操作语义刻画其生命周期。其元理论把单组件的时空可组合性推广到由交错组件构成的整个系统。
- 在 Cordis 中实现这些思想(第 5 节)。Cordis 是一个支持时空可组合性的元框架,提供以效应追踪和余效应解析实现形式模型的核心库,以及支持配置协调和热模块替换的声明式组件加载器。
1数据于 2026 年 6 月 9 日从 Visual Studio Code Marketplace 获取。
2. 预备知识
本节简要概述效应系统与余效应系统,它们是本文工作的两项理论支柱。我们假定读者熟悉基本类型论和范畴论;本节旨在固定记号,并引入第 3 节将作为运行时机制加以操作化的关键抽象。
2.1. 效应
在简单类型 lambda 演算(STLC)[20, 21] 中,类型判断 表示项 t 在上下文 下具有类型 T。效应系统通过描述计算可能产生何种副作用来细化类型,得到如下形式的判断:
这里,结果类型由某个效应代数的元素标注,用以描述计算可能产生的副作用,从而能够对有状态计算进行组合式推理。该思路始于 Lucassen 与 Gifford [22]:他们引入一种区分类型、效应和区域的 kinded 类型系统,以发现并行程序中的调度约束。
**单子(monad)效应。**Moggi [16] 首先利用单子从范畴论角度建模计算效应;Wadler [23] 则在 Haskell 中推广了这一方法。范畴 C 上的单子 (T, η, μ) 将有效应的计算封装为类型 T(A) 的值,其中 将纯值提升, 对嵌套计算进行顺序化。经典实例包括 Maybe 单子(部分性)、State 单子(可变状态)和 IO 单子(外部交互)。
**代数效应。**Plotkin 与 Power [17, 24] 证明代数操作能够确定单子,由此建立了一个将效应接口与其实现解耦的框架。效应签名 声明一组操作(例如状态的 、);程序可自由调用这些操作,而无须承诺某种特定解释。随后,Plotkin 与 Pretnar [25] 引入效应处理器(effect handler),它通过提供延续语义解释操作:
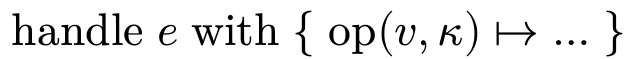
处理器接收操作参数 v 和受界定的延续 κ;它可以零次、一次或多次调用该延续,从而在统一框架下实现异常、协程和非确定性 [26]。Koka [27, 28]、Eff [29] 和 OCaml 5 [30] 等语言已在不同设计取舍下采用代数效应。
2.2. 余效应
与效应对偶,余效应系统 [18, 31] 丰富的是上下文而非类型,得到如下形式的判断:
这里,上下文由余效应代数的元素标注,描述计算从环境所需的内容,例如要访问的资源、要持有的权限或要依赖的服务。效应建模程序对世界的影响,余效应建模世界施加于程序的约束。
**余单子(comonad)余效应。**使用余单子组织上下文相关计算的思想最早由 Uustalu 与 Vene [32] 提出。他们提出对称(半)幺半余单子,作为 Moggi 单子效应框架的对偶,用以刻画数据流和属性求值等概念。Petricek 等人 [18] 在此基础上提出余效应,将其作为上下文依赖的统一静态分析。余单子 刻画上下文相关计算: 从上下文中取出当前值, 为嵌套访问复制上下文。环境余单子 刻画对固定环境 E 的依赖;流余单子 刻画对时序数据的依赖。
**分级余效应。**为进行更细粒度的追踪,分级余效应系统使用预序半环 作为余效应代数 [33];Gaboardi 等人 [19] 后来将这一纪律与分级效应统一。S 的元素标注每个变量绑定,以量化其使用情况:0 表示未使用,1 表示线性使用,n 表示有界使用, 表示无约束使用。半环操作可将余效应按顺序()和并行(+)组合,从而在统一的代数框架 [37] 中实现精确资源追踪、敏感性分析 [34] 及信息流控制 [35, 36]。
2.3. 与动态可组合性的关系
效应系统和余效应系统沿两个互补方向组织对计算的推理:效应描述计算如何修改环境,余效应描述计算如何依赖环境。这两个方向对应于第 1 节识别出的动态可组合性的两个维度:
- 时间可组合性要求:组件卸载时,它对共享环境所做的修改必须可逆。相关的是持久地变换该环境的有状态效应;撤销此类变换要求它存在逆元。
- 空间可组合性要求:组件间依赖必须被声明并以反应式方式管理。这种依赖正是余效应所刻画的内容;管理它等价于依据环境提供的内容逐一解析这些依赖。
但是,经典效应和余效应系统都是静态工具:效应在词法范围固定的作用域内被追踪,并由编译期处理器消解;余效应标注则相对于执行前已确定的上下文加以验证。相反,动态组合要求这些保证面对持续演化的上下文,仍对运行时到达和离开的组件成立。部署后加载的插件无法由任何固定词法作用域界定;运行时配置产生的依赖也无法由任何编译期上下文预先穷尽。
这促使我们转换视角:与其用更多标注扩展静态类型系统,不如将效应和余效应的概念结构实体化,使运行时能够直接操作它们,从而动态地建立原本由这些系统静态提供的保证。
3. 可逆效应与反应式余效应
本节将第 2 节引入的效应和余效应概念提升为运行时机制,构建动态组合理论。核心思想是将承载效应和余效应的类型判断上下文转化为上下文类型(context type),亦即将上下文实体化为可在运行时操作的一等实体。对于效应类型,我们将其建模为带有逆变换的上下文变换,以实现局部时间可组合性;对于余效应上下文,我们将其建模为携带依赖信息的类型,以实现局部空间可组合性。余效应上的观测等价关系继而为效应提供独立性。承载两类信息的统一上下文本身即构成一种编程范式。
3.1. 可逆效应
时间可组合性是指:在运行时加载和卸载组件时,卸载操作能够将共享环境恢复到组合发生之前的状态。这要求组件对环境的每次修改都既可追踪又可恢复。因此,我们将效应建模为类型 的函数:作用于当前上下文时,它返回修改后的上下文及一个显式逆变换。提供该逆变换使效应可被撤销;将它交给运行时则使效应可被追踪。我们称这样的效应为可逆的:在执行期间追踪并组合这些逆变换,便可将完整环境恢复确立为一种结构性保证。
3.1.1. 效应上下文
给定任意不纯函数 ,我们将其转换为纯形式 ,其中 是上下文,所有可能的副作用均可表示为对 的变换。对于任意固定输入 x : X,诱导映射 独立于返回值地捕获 f 的副作用。因此, 上的效应位于变换 在复合 ∘ 下构成的幺半群中;每条幺半群公理都可直接解读为效应性质:
- 封闭性:两个效应的顺序复合仍是效应;
- 结合性:组合效应不依赖于如何加括号;
- 恒等性:( 上的恒等函数)是复合的单位元。
为建模可撤销的效应,我们将每个变换 f 与另一变换 g 配对,令 g 撤销 f;称 g 为 f 的左逆,本文随后均简称为“逆”。撤销是单侧的:逆元应满足的是 g ∘ f,而不是 f ∘ g。变换对本身也带有一种乘法:
定义 1. 以下式定义上下文变换对的扭曲复合:
和 ∘ 本身一样,左操作数在右操作数之后作用;逆元则按相反的顺序累积。这使 成为以 为单位元的幺半群,即变换幺半群与其反向幺半群的乘积。我们将其称为 上的扭曲复合幺半群 。
为在上下文本身中追踪效应,引入如下定义。
定义 2. 给定上下文 ,将其效应上下文定义为:
它可理解为一对 ,其中:
- 为当前上下文状态;
- 为累加器,即迄今已执行效应的逆变换之复合,也是将上下文恢复到初始状态的函数。
特别地,初始效应上下文可表示为 。我们还记 ,并可沿此塔式结构继续定义更高层。
由于有累加器 ,对 执行的所有效应均可追踪和恢复。下面给出追踪与恢复的具体构造。
定义 3. 在上下文函数对上定义变换 :
该变换将前向函数 f 及候选逆 g 转换为效应上下文 上的变换。将 作用于状态 时,先用 f 变换 ,再把逆 g 复合到 上,从而在上下文中追踪 f 的效应。
定理 4. 对每个 ,下图交换,即:
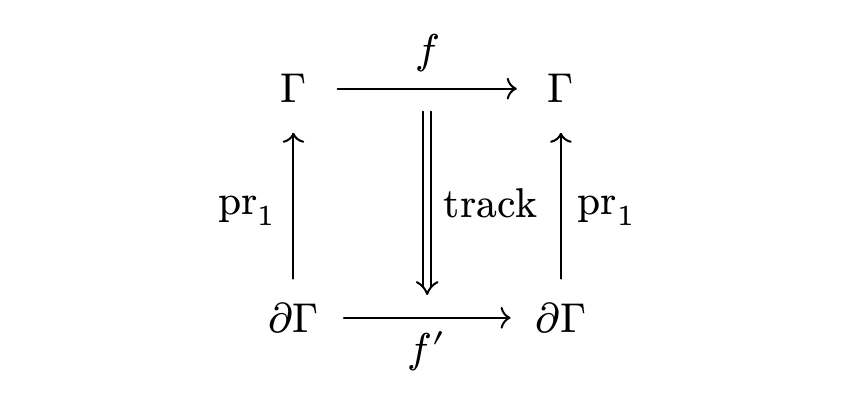
**证明。**对任意 :
定理 5. 是从 到 的幺半群同态。也就是说:
- ;
- 对任意 ,
证明。
- 单位元被映为单位元,因为 。
- 对乘法,取任意 :
定义 6. 在 上定义变换 :
该变换将恢复函数 作用于当前状态 ,并将 重置为恒等函数。若依次对 应用一串效应 track(f₁, g₁), …, track(fₙ, gₙ),则随后应用 recover 会将上下文恢复到其初始状态。每个追踪步骤所保持的是从任意状态出发的恢复结果本身:
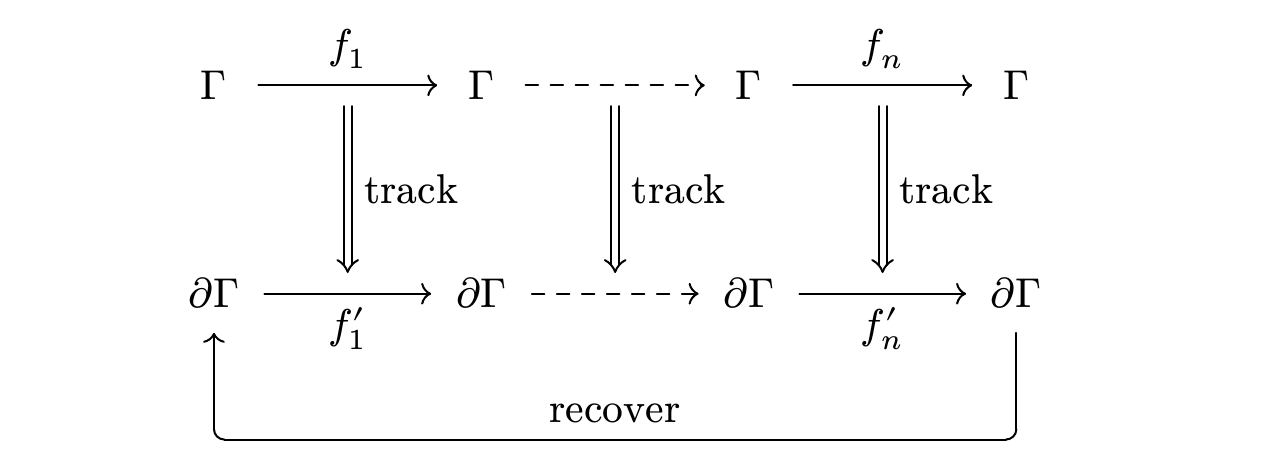
定理 7. 对任意 ,以及满足 的任意函数对 (f, g),有:
证明。
对于一串函数对,无须另行论证。设 (f₁, g₁), …, (fₙ, gₙ) 从 开始按顺序应用,并记 、。由定理 5,复合 等于扭曲复合 (fₙ ∘ … ∘ f₁, g₁ ∘ … ∘ gₙ) 的 。如果每个 i 都有 ,则 。该函数对因而在 满足定理 7 的前提,一次应用该定理即可得到:
取 时,恢复会把以此方式到达的每个状态带回 。若函数对满足 ,则它在每个状态都满足前提。恢复通过量 读取一个状态;我们将 称为 中状态的健全性不变量。
3.1.2. 可逆效应函数
上一节的 track/recover 模型将逆元视为先验给定: 在观察到任何上下文状态之前即固定 g,所以同一个 g 必须适用于效应所作用的每个状态。然而在实践中,每个效应的逆并非先验已知;它必须由调用者在施加效应的位置提供。此外,recover 是全有或全无的:它不能在保留其他效应的同时选择性撤销某一效应。为解决这两个问题,我们同时增强模型的输入端和输出端:
- 在输入端,我们不仅变换 ,还一并返回逆函数,使逆元在施加效应的位置被提供:,即 ;
- 在输出端,我们不仅变换 ,也一并返回逆函数,从而可以撤销一个效应而保留其他效应:,即 。
这种增强保持了输入和输出之间的结构一致性,因此我们仍可定义与 track 相应、维持其数学性质的理论。所得类型为效应函数 及其带见证的细化 :
定义 8. 将效应函数 与带见证效应函数 定义为:
其中, 产生一对 ,表示:
- 是新的上下文;
- 是当前效应的逆函数。
的一个元素会为每个状态选择其逆元;约束 要求该选择确实能撤销效应在其施加位置的作用,而在其他位置 g 不受约束。若存在单个 g 满足 ,则它同时在所有状态上满足该约束,并通过 诱导一个 元素;定理 11 将证明这是一种同态。该约束可由交换图表示:它确保 e 返回的逆变换确实在 e 被施加的状态上逆转该变换。
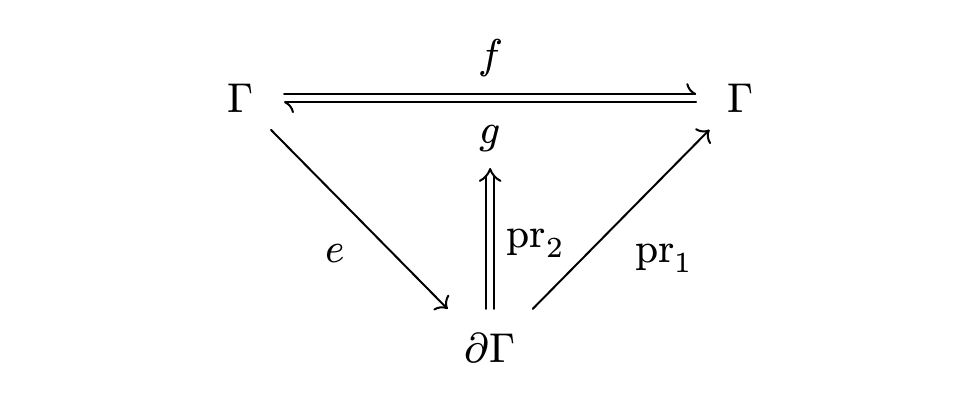
由于效应函数 已不再是上下文上的自同态,不能直接复合。因此定义新的效应复合运算。
定义 9. 给定 ,定义它们的效应复合 f ⋄ g:
定理 10. 效应复合将 的幺半群结构带到 上。也就是说:
- 是以 为单位元的幺半群;
- 赋值 是从 到 的幺半群同态。
证明。
- 结合律与单位律逐分量地继承自
∘的对应性质。 - 记 ,则 ,这正是
(f₁, g₁) ∘ (f₂, g₂)的像;而 映为 。□
定理 11. 见证性质在效应复合下保持,且统一逆元在每个状态上都是见证。即:
- 是 的子幺半群;
- 定理 10 的同态会将每个满足 的函数对映入 。
证明。
- 单位元属于 ,因为 。对于封闭性,取 及任意 ,令 、,则 。由 和 ,可得 。
- 蕴含在每个 上都有 ,故此类函数对的像在每个状态都有见证。□
正如 track 将 上的一对变换提升到 上,定义 effect 将 提升到 。
定义 12. 定义效应函数变换 :
由于 本身属于 ,它返回的内容是按定义 8 上移一层理解的逆元。该逆元本身是对通过交换效应两方向得到的函数对的 。普通追踪规则再次适用:撤销该效应本身也是一个效应,它通过 变换状态;而撤销这一撤销的方式是再次施加该效应,即 。故该逆元恰好按 的规定复合到所接收的累加器上。
现在可以证明 effect 具有与 track 类似的性质。
定理 13. effect 保持 ⋄ 运算。即,对任意 :
**证明。**取任意 ,并令 、,从而 ,且 。于是:
第一步是在 和 处展开定义 12;第二步使用定理 5;第三步折叠定义 12。□
下图所表达的是两层之间的关系:其上三角形是定义 8 所述的 的见证条件;下三角形询问的是 是否以与 相同的方式具有见证。在层与层之间,投影 将每个提升后的映射关联到其所提升的映射,正如定理 4 对 所示。
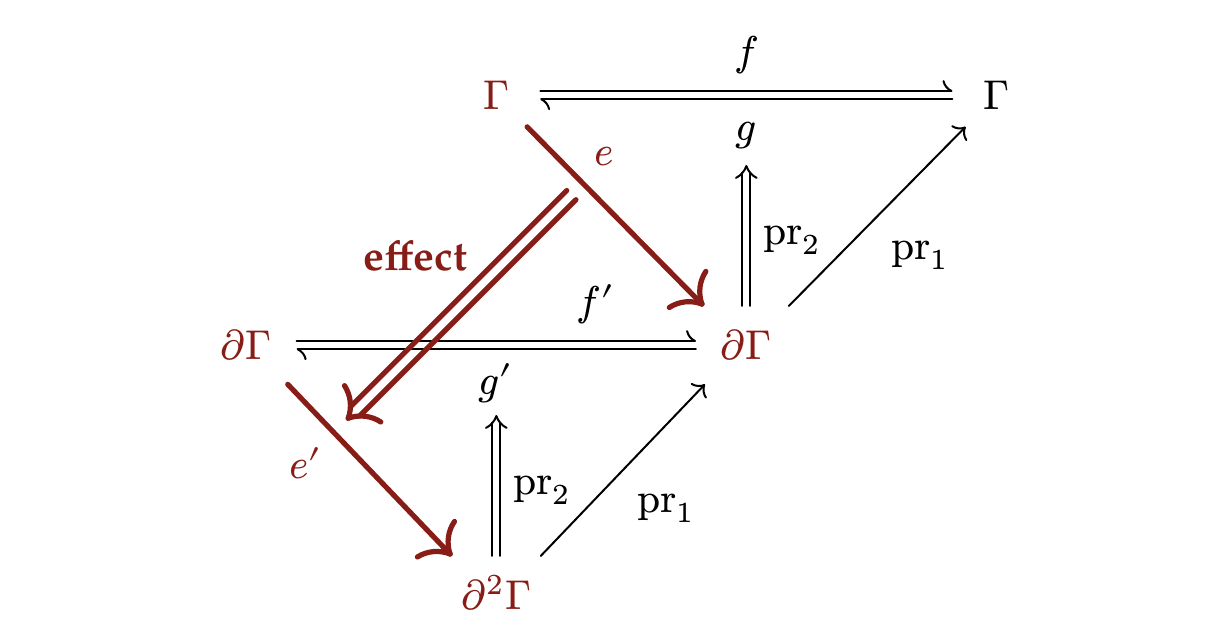
定理 14. 令 ,记 ;令 ,其前向映射为 。则:
- ;
- 对每个 ,提升后的逆 与其处的逆 满足 。
证明。
- 由定义 12,,其状态分量为 。
- 这是对 应用定理 4。□
下三角形是否闭合,可通过计算提升后的逆返回什么来判定:
定理 15. 令 ,并记 。固定 ,令 ,并记 在 处的值为 。则:
状态会被精确恢复。当且仅当 时,累加器也会恢复,等价地 ;并且在所有情形中,,故健全性不变量得以保持。
**证明。**由定义 12, 且 ,所以:
其中使用了 。属于 要求该结果在每个输入处都等于 ;取 时,累加器相等便等价于 ,反之该条件使累加器对每个 都相等。最后,。□
因此,仅当在 处见证的逆在每个状态都撤销 f 时,下三角形才会闭合; 不会把 映入 。每种情形下均成立的是在 处的一致性:。这正是定理 7 对累加器的全部要求,所以撤销不会改变恢复目标。
按施加顺序的反序撤销效应不需要任何额外条件,因为此时每个逆元都会遇到其自身施加所产生的状态:
定理 16. 设 从 出发按顺序施加,并按相反顺序撤销。则:
- 每次撤销均恢复其对应施加操作所面对的上下文状态;
- 每个中间状态均满足健全性不变量。
**证明。**每一步要么施加,要么撤销。一次施加将 变为 ,且 ,故由定理 7 保持 ;其前提恰是 的见证。反序撤销将每个逆元交给它自身的施加所产生的状态,因此由定理 15,该撤销会精确恢复前一状态,并同样保持 ;两个结论都不依赖逆元所接收的累加器。□
3.1.3. 效应的独立性
定理 16 处理的是在效应自身施加所产生的状态上撤销它;本小节处理的是在其他任意状态上撤销它。后者有两种典型情形:其一,后续效应仍然存在时运行一个逆元,这正是从运行中系统撤回一个组件所做的事;其二,一个序列交错多个组件的效应,且每个组件持有自己的逆元,于是一个组件的逆元会被另一个组件的施加操作隔开。二者中,逆元遇到的是已被外来效应移动的状态;它能否仍撤销其原本要撤销的内容,取决于交换性:一个效应所能执行的每个变换,都必须与另一个效应所能执行的每个变换交换,包括前向映射和所返回的逆元。单一累加器不能解决这两种情形,因为 会按一个顺序、一次性运行其保存的所有逆元。
定义 17. 对效应函数 ,其变换幺半群 \mathfrak{M}(e) 是 的子幺半群,由 e 的前向映射和 e 在所有状态返回的每个逆元生成;\mathfrak{M}(e) 的生成元即该生成集合中的元素:
由函数对 诱导的效应以 f 和 g 为生成元,因为它在每个状态均返回逆 g。
引理 18. 交换性可在生成元上判定,且 ⋄ 不会扩大变换幺半群。即:
- 若
M(e₁)的每个生成元均与M(e₂)的每个生成元交换,则M(e₁)的每个元素均与M(e₂)的每个元素交换; M(e₁ ⋄ e₂) ⊆ ⟨M(e₁) ∪ M(e₂)⟩。
证明。
- 与
M(e₂)的每个生成元交换的映射,在 中构成子幺半群: 属于其中;若f和f′属于其中,则f ∘ f′亦属其中。该子幺半群由假设包含M(e₁)的生成元,故包含M(e₁)。固定 ,与f交换的映射同样构成包含M(e₂)生成元的子幺半群,故包含M(e₂)。 - 由定义 9, 的前向映射为 ,它在任意状态返回的逆为: 返回的某个 与 返回的某个 的复合 。所以 的每个生成元都是两者生成元的复合。□
定义 19. 当且仅当满足下列条件时,效应函数 独立:
- 一方的每个变换均与另一方的每个变换交换:
- 一方的变换不扰动另一方产生的逆元:
并对交换 e₁、e₂ 后的情形同样要求成立。
若对每个 l ≠ l′,eₗ 与 eₗ′ 独立,则族 称为两两独立。一个族可以重复某个效应函数;一个效应与其自身独立,意味着 \mathfrak{M}(e) 可交换。
对于由函数对 (f₁, g₁) 和 (f₂, g₂) 诱导的效应,子句 (1) 由引理 18(1) 等价于四对映射 f₁, f₂、g₁, g₂、f₁, g₂ 与 g₁, f₂ 的交换;子句 (2) 则自动成立,因为诱导效应在每个状态都返回同一逆元。⋄ 下的交换是另一性质:e₁ ⋄ e₂ = e₂ ⋄ e₁ 比较的是两种顺序的组合前向映射及组合逆元,且每个逆元进入组合时均在其自身施加所产生的状态;而独立性则把一方的每个变换与另一方的每个变换关联起来,其中包括前向映射与外来逆元的配对。
在独立性条件下,可在被后续效应移动的状态运行一个逆元;它在那里撤回的仅是自身的贡献:
定理 20. 令 从 出发按顺序施加,且两两独立。记 ,令 、,并令 为 在施加处返回的逆。固定 ,令 表示省略 后该序列的状态,故 。则对每个满足 的 :
- ,且 ;
- 每个
i > j的eᵢ在 处返回的逆,与其在 处返回的逆gᵢ相同。
证明。
- 第一式对
u归纳。在u = j时,它就是 ,即 的定义。归纳步为:
中间等式由定义 19 的子句 (1) 对 eᵤ₊₁ 与 eⱼ 得出,因为 u + 1 > j 时它们是该族中不同的效应。第二式中,子句 (1) 将 gⱼ 穿过在 eⱼ 之后施加的前向映射,直至可在它所适用的唯一状态使用 eⱼ 的见证:
最后一个等式基于 gⱼ(fⱼ(δⱼ₋₁)) = δⱼ₋₁,即定义 8 对 eⱼ 在 δⱼ₋₁ 处所要求的见证。
- 由 (1),状态 为 ,且 ;所以对 和 应用定义 19 的子句 (2),得到 。□
子句 (1) 指出一个逆元到达的状态:无论后续施加了什么效应,它都是“若该效应从未施加,原序列会到达的状态”。子句 (2) 指出其他效应在该状态所持有的逆元。二者结合,可再次将定理应用到较短序列:
推论 21. 令 从 出发按顺序施加且两两独立,并令 如上。若在 处按 的任意一个置换顺序施加这 个逆元,则会到达 。
**证明。**对 n 向下归纳。设该置换以 j 开始。由定理 20(1),在 δₙ 处施加 gⱼ 到达 δ′ₙ,即省略 eⱼ 后序列到达的状态;由定理 20(2),余下效应在该处返回的逆元正是手中的 gᵢ。该序列作为子族仍两两独立,故可对它及该置换的余下部分应用归纳假设;空序列到达 γ₀。□
LIFO 顺序是上述置换之一,且定理 16 无须任何前提便可按此顺序撤销。独立性带来的额外能力是任意其他顺序,以及交错多个组件的序列;第 4.4.2 节会将此结论推广到整个系统的轨迹。
综上,这些构造构成了可逆效应: 中的每个效应函数均显式提供自身逆元, 在效应上下文 上追踪这些逆元, 运算则在保持可逆性的同时将其组合。它们提供的是局部时间可组合性,其中“局部”表示保证只针对一个组件自身所施加的效应来解读。我们采用如下判据:对组件施加的每个效应函数序列,累加器都恢复其开始时的上下文(定理 7),且撤销该序列时,每个逆元均接收其自身施加所面对的状态(定理 16)。加载组件就是施加这样的序列并在 中累积其逆元;卸载组件就是施加 。
该判据遗漏两件会在多个组件参与时出现的事:按累加器强加的顺序之外的顺序撤销,以及与其他组件效应交错的序列。独立性可处理二者(推论 21),但它是施加于效应的条件,而非构造本身的性质。第 3.3.2 节识别出满足该条件的纪律,第 4.4.2 节则将保证解读为整个系统轨迹的性质。若独立性不成立,顺序必须在其他地方被承载:单个组件内部由累加器承载,无论效应如何均按 LIFO 顺序撤销(第 4.3.2 节);跨组件则由已声明的余效应承载,它将一个激活操作排在另一个之前(第 4.3.1 节)。
3.2. 反应式余效应
空间可组合性是指组件能够彼此声明依赖,系统则能够在运行时解析、提供和撤回这些依赖。这要求共享上下文每次变化时,都重新求值依赖是否得到满足:依赖变为可用时激活组件,依赖被撤回时停用组件。因此,我们将组件的依赖建模为一种规约,并针对该规约将上下文的每次改变分类为激活、停用或中性。相对于规约进行分类的是检测满足性变化的部分;对该分类作出响应的则是驱动激活和停用的部分。我们称此类余效应为反应式:通过对上下文变化进行分类,并由分类驱动激活和停用,正确的余效应排序成为一种结构性保证。
3.2.1. 余效应上下文
传统控制反转(IoC)容器 [38] 通常将依赖建模为简单的键值映射。本节将 IoC 形式化为余效应上下文;它与可逆效应协同,为动态组合提供数学基础。
定义 22. 给定类型族 V : K → Type,将余效应上下文定义为依赖偏函数类型:
其中 σ : Σ 是有限偏函数,它为每个 k ∈ dom(σ) ⊆ K 赋予类型为 V_k 的值。记号如下:
σ(k)表示函数应用(当k ∈ dom(σ)时有定义);σ[k ↦ v]表示在k绑定v、其他位置与σ一致的表;σ ∖ k表示限制(当k ∈ dom(σ)时有定义);k ∈ dom(σ)表示成员关系。
类型族 V 的使用确保每个依赖键 k 都关联到特定值类型 V_k,从而为依赖访问提供静态类型安全。扩展和限制带有由下列操作施加的前置条件:依赖不能被提供两次(扩展要求 k ∉ dom(σ)),也不能在不存在时被撤销(限制要求 k ∈ dom(σ))。违反前置条件会以错误形式发出信号且不产生转移,因此描述实际发生转移的效应代数可原样应用于这些操作。若读者倾向于内化失败,可将下文所有 Σ ⇀ Σ 理解为 Σ → Maybe(Σ),并在 Maybe 单子(第 2.1 节)中复合;代价是每个恒等映射需替换为相应操作定义域上的部分恒等映射。基于这一上下文结构,定义两个核心操作。
定义 23. Σ 上的 get 与 set 操作定义为:
其中 get(k) 以前置条件 k ∈ dom(σ) 为要求,set(k, v) 以前置条件 k ∉ dom(σ) 为要求。
值得注意的是,set(k, v) 具有类型 ,正是余效应上下文上的效应函数。因此可以直接应用第 3.1 节的效应机制: 为依赖注册提供自动追踪与恢复。这就是反应式余效应与可逆效应之间的协同:余效应操作是效应,而效应是可逆的。
get 交给组件的是一个值,而组件能用该值做什么,取决于该键上的余效应提供了什么。因此,一个键所携带的不仅是值类型。
定义 24. 键 k 上的余效应是三元组 (V_k, ≃_k, A_k),其中 V_k 是定义 22 中的值类型;≃_k 是 V_k 上用于比较键 k 处值的等价关系(第 3.3.2 节);A_k 是一组余效应操作,即绑定在 k 处的值向持有该值的组件提供的操作。操作 a ∈ A_k 带有参数类型 X_a 和结果类型 B_a,并只作用于该值:
其前两个组成部分构成 V_k 上、按定义 8 要求具有见证的效应函数;第三个组成部分为结果。每个操作都要求尊重 ≃_k:在 ≃_k 相关的值上,它要么两处都有定义,要么两处都无定义;若有定义,则产生 ≃_k 相关的后继、会再次把 ≃_k 相关值带到 ≃_k 相关值的逆元,以及相等结果。一个操作通过以下提升作用于余效应上下文:
该式在 k ∈ dom(σ) 时有定义,其前两个组成部分是 Σ 上的效应函数。
将 k 的操作类型化为作用于 V_k,正是将其限制到 k 处绑定的原因:提升后的操作读取并写入该绑定,其他键保持不变,因此无须额外侧条件说明这一点。在启用隔离(isolation)时,它实际到达的绑定是 realm 解析到的绑定(定义 28);两个键若共享一个 realm,便共享同一绑定。若某个操作的行为取决于另一个键,它会将该键的值读入自己的参数 X_a;下一小节的反应式纪律会保证,只要读取该值的组件在运行,该值便保持固定(定理 63)。
3.2.2. 规约与通知
前述定义说明了单个依赖如何注册和访问。然而,访问不存在的依赖会导致运行时失败。因此,组件应在其声明的全部依赖都存在之后才被激活,而不是乐观地访问依赖并在某项缺失时失败。由此产生两个问题:组件声明的依赖是否被共同满足,以及当该状态发生变化时系统应如何响应。余效应上下文 Σ 携带一种自然的观测结构,使两个问题均可处理:对任意余效应规约 d ⊆ K,定义满足性谓词:
该谓词是可判定的(因为 dom(σ) 有限)。由于对 σ 的所有变更都通过效应函数发生(其逆元恢复先前定义域),满足性变化可在每个效应边界被检测到。这是反应性的代数基础:效应系统保证每个余效应变化都被观测。
定义 25. 余效应规约为:
表示组件从环境声明的一组依赖。
使该规约具有反应性的,是它对状态转移的分类方式。任意将 变换为 的效应,都可由规约 按照 的满足状态是否改变来分类。
定义 26. 给定余效应规约 d ⊆ K 和状态 σ, σ′ ∈ Σ,定义:
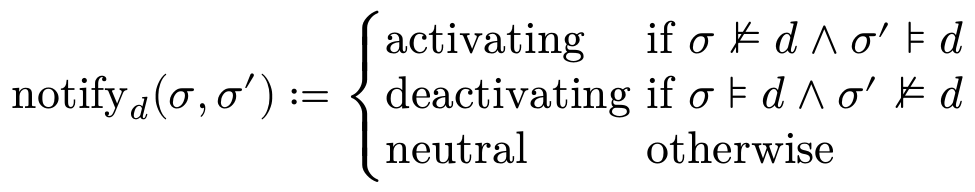
该定义良好,因为 σ ⊧ d 可判定,且所有状态转移都由效应函数中介。反应式不变量为:激活型转移触发组件效应的执行(并带有完整效应追踪),停用型转移触发通过施加累加器完成的恢复。这些转移与控制流交互时的精确操作语义将在第 4 节展开。
set 与 notify 共同提供的是局部空间可组合性,其中“局部”与前文含义一致:保证只针对单个组件自身的余效应来解读。我们采用如下判据:组件只在满足其规约的状态下激活,因此不会读取不存在的绑定;上下文的每次变化都会按该规约分类,因此满足性的丧失会在发生处被检测到,并驱动停用。两部分都直接来自上述定义:满足性是在组件激活处检查的前置条件,而 notify_d 在每个转移处都有定义。
该判据覆盖余效应排序的一个方向,而非另一个方向。若组件 A 提供键 k,组件 B 声明 k ∈ d_B,则 B 只能在 A 已激活并提供 k 后激活,因为 σ ⊧ d_B 要求 k ∈ dom(σ)。反向并不成立:卸载 A 会从 dom(σ) 移除 k,从而破坏 B 的满足性;但通知本身无法在 B 自身拆卸过程需要读取 k 的期间保持其可读,也无法推迟 A 的恢复直到 B 完成。将一次撤回排在它导致的停用之后,是施加于其他组件的条件,而非施加于当前行动组件的条件;因此它属于全局形式的保证,第 4.3.1 节会提供所需机制。
3.2.3. 隔离与拦截(interception)
基本余效应上下文 Σ 建模的是一张扁平依赖表。但实践中,系统可能需要为不同组件将同一逻辑依赖绑定到不同值。本节以两种机制扩展余效应上下文:余效应隔离(同一键在不同上下文中解析为不同值)与余效应拦截(在依赖访问上施加横切行为)。
**实现方式。**这两种机制与 get、set 的差异在于它们作用的对象不同。一次提供会写入每个组件读取的共享表,因此它是该表上的效应,并携带用于撤回的逆元。隔离和拦截则调整某一上下文之下组件如何解析某个键,而不改变表本身。将一个操作类型化为效应,会固定其指称,即后继状态与逆元配对;但不会固定其实现方式,后者决定该逆元如何被执行。
定义 27. 上下文上的效应函数有两种实现方式:
- 原地实现会修改上下文并返回非平凡逆元;后继与输入别名,恢复时运行逆元以撤销修改。
- 派生实现保持输入不变,并返回一个从输入派生的新上下文,其逆元为恒等函数;恢复时丢弃该派生上下文。由一个上下文派生出的上下文,正是定义 32 的递归结构所承载的内容。
在纯函数式场景中,二者重合;命令式宿主可对每个操作选择其一,第 5.1.2 节实现了两者。隔离和拦截直接采用派生实现:二者均产生自己的表不同于继承表的新上下文,因此下文将其类型化为从上下文到上下文的映射,而非效应函数。共享表没有发生改变,所以没有逆元需要追踪,也没有内容需要定义 12 提升;恢复时会丢弃派生上下文以及它携带的调整。派生表上的赋值会覆盖继承表在该键处保存的内容,因此两个操作都不带前置条件。
**余效应隔离。**通过引入隔离 realm,余效应隔离允许同一依赖在不同上下文中绑定到不同值。这可广泛用于多租户系统、测试环境和组件沙箱。
定义 28. 将带隔离的余效应上下文定义为:
它可表示为一对 (ρ, σ),其中:
ρ : K ⇀ R是隔离 realm 表,为每个被隔离的键分配 realm 标识符;不在dom(ρ)中的键解析到自身的 realm,因此在该处记ρ(k) = k(R ⊇ K);σ : (r : R) ⇀ V_r是依赖表,即从 realm 标识符到带类型值的依赖偏函数。
这种两层映射结构将逻辑层与存储层解耦,使依赖访问具备上下文感知能力。访问键 k 时,系统先解析 ρ(k) 得到 realm 标识符 r,再访问 σ(r) 以取得实际值。
定义 29. Σ_iso 上的 get、set 与 isolate 操作为:
其中 get 与 set 携带定义 23 的前置条件,并沿 ρ 传递,即分别要求 ρ(k) ∈ dom(σ) 与 ρ(k) ∉ dom(σ)。由 isolate(k, r) 派生出的上下文把 realm r 分配给 k,并原样继承依赖表;因此,对已被隔离的键会重新分配,而非拒绝。
余效应隔离机制本质上实现了一个运行时 ad-hoc 多态系统。通过隔离 realm 标识符,同一依赖键可以在不同上下文中解析为完全不同的值,且这种多态可在运行时动态调整。相比传统依赖注入,余效应隔离提供更细粒度的控制,可对特定组件启用定制化隔离;set 仍是效应函数()并因此继承可逆性,而 isolate 不需要可逆性,因为它是派生一个上下文而非写入共享表。
**余效应拦截。**第二种机制是余效应拦截:它为依赖访问附加横切元数据,在不修改依赖值的情况下添加行为。该元数据既可由上下文携带,也可由组件声明,因此需要同时扩展余效应上下文与余效应规约。
定义 30. 定义带拦截的余效应上下文与规约:
上下文 是一对 : 是安装在上下文本身上的、由上下文携带的元数据,默认为空(); 将每个键 映射到一个从元数据 到值 的提供者函数。规约 携带由组件声明的元数据,为每个键分配其元数据 ,并以 作为依赖集合。每个键为其元数据配备幺半群 :合并运算 满足结合律,并以 (空元数据)为单位元。
定义 31. Σ_inter 上的 get、set 与 intercept 操作为:
其中 get 和 set 对提供者表携带定义 23 的前置条件,即分别要求 k ∈ dom(σ) 与 k ∉ dom(σ)。由 intercept(k, ν) 派生出的上下文会把 ν 合并到继承的 k 处元数据上,并原样继承提供者表。
当规约为 d 的组件访问键 k 时,系统求值 σ(k)(d(k) ⊕_k ι(k)):组件声明的元数据与上下文携带的元数据 ι 合并,再将提供者函数作用于合并结果。该合并遵循每个键自身的语义(例如标量字段被覆盖、集合值字段取并集),且右偏,因此 ι(k) 优先,可覆盖组件声明,使外围上下文能在不修改组件的情况下约束其使用余效应的方式(例如第 6.3 节)。
3.3. 上下文范式
第 3.1 节和第 3.2 节各自作用于上下文:前者将上下文作为效应的承载者,后者将上下文作为余效应的承载者,但二者尚未说明一个同时承载两者的单一上下文应如何构成。本节给出该统一的具体构造,从余效应组装出一种观测等价关系,以提供第 3.1.3 节尚未解决的效应独立性,并论证所得上下文类型本身构成一种编程范式。
3.3.1. 统一上下文
对上下文 而言,效应上下文 (第 3.1 节)提供了一层更高抽象,承载上一层上下文和该层的累加器(定义 2)。将此结构递归化并与余效应上下文 结合,得到如下类型:
定义 32. 上下文类型 定义为:
三个投影分别为:
- :当前上下文状态(递归);
- :累加器,用于恢复本层效应;
- :承载依赖信息的余效应上下文。
在该定义下, 将 映射到自身,从而把 塔统一为一个自相似类型。余效应上下文 以结构化方式集成其中:依赖操作(set、get)作用于 ,累加器追踪它们的逆转。由于 底层的类型族 不受约束,系统需要在组件间共享的任何状态都可以编码为带有适当值类型的依赖; 因而涵盖所有共享可变状态,而不仅仅是组件间依赖。组件与其环境之间的每次交互都通过这一单一实体发生。
层级组合。 的递归结构支持层级控制:父上下文聚合多个子层级效应,形成树形控制结构;该结构既保持模块性,又允许统一的跨层级管理。效应变换实现了字面意义上的“插件式”隐喻:
- 加载组件对应于执行其效应(插入);
- 卸载组件对应于恢复其效应(拔出,且不影响其他正在运行的组件);
- 层级中不同层次的组件可独立加载和卸载;父上下文聚合并管理其所有子组件的效应,从而支持任意嵌套的组合。
3.3.2. 观测等价
第 3.1 节的恢复保证断言状态相等(定理 7),这是一种理想化,因为物理状态不可能恢复到完全原样。例如,free 会把一个块释放给分配器,而不会恢复 malloc 前的堆布局;生成性名称也不会由丢弃它的逆元恢复,因为下一次创建会取得一个新名称 [39]。因此,第 3 节中的相等应当按某个等价关系 ≃ 来理解;我们取 ≃ 为观测等价:当没有观察者能区分两个状态时,二者相关。比较行为而非表示,是程序等价的既有路径 [40];这种比较得到的关系取决于观察者可用的内容 [41]。上下文的观察者可用的是其携带的余效应,而每个余效应都有自身的等价关系(定义 24),所以上下文上的关系由这些关系组装而成。本小节负责进行该组装;再对其取商,便得到第 3.1.3 节所要求的独立性。
定义 33. 当两个余效应上下文把同一组键绑定到相关值时,称二者相关;当两个上下文状态的余效应投影相关时,称二者相关:
其中 σ_γ 表示 γ 的余效应投影(定义 32)。
一个状态中没有被任何键绑定的部分由此被遗忘;正是这种遗忘使定理 7 能按 ≃ 解读:上面例子中的堆布局和生成性名称均处在该关系之外,除非有某个键绑定了它们。第 3.2.2 节所需的 ≃ 性质由此推出,而非作为假设加入。相关状态具有相同定义域,因此它们在满足性谓词 σ ⊧ d 和定义 26 的分类 notify_d 上一致;反应性是 Σ / ≃ 的性质。
称该关系为观测性的,是对每个 ≃_k 的主张:它区分的内容不应超过键 k 的操作所能分辨的内容。对值的观察者会运行这些操作并读取其结果。
定义 34. 令 V 按定义 24 携带一组操作 A,并令 \mathfrak{M}(a) 表示每个参数 x : X_a 下效应函数 a(x) 的变换幺半群(定义 17)。A 上的一个测试是由各 \mathfrak{M}(a)(a ∈ A)的生成元构成的有限字;每个字母都作用于此前字母留下的值。测试的结果是沿途那些作为操作前向映射的字母所产生的结果;若前置条件失败,则测试无定义。值 v, v′ : V 不可区分,记为 v ≈_A v′,当且仅当每个 A 上的测试在二者处要么均有定义、要么均无定义,且在二者处产生相同结果。
引理 35. 不可区分性是操作所尊重的最粗关系。即:
A的每个操作都按定义 24 的意义尊重≈_A;- 每个被
A的所有操作尊重的等价关系都包含于≈_A。
因此,每个可采纳的 ≃_k 都包含于 ≈_{A_k},且 ≈_{A_k} 本身可采纳。
证明。
- 令
v ≈_A v′,并将a ∈ A作用于某个参数。给测试加上一个字母作为前缀仍是测试;因此前向映射到达的值不可区分,任意一个返回的逆元从不可区分参数出发到达的值也不可区分;单字母测试给出两处定义性一致和结果相等。 - 令
R为这样的等价关系且v R v′。测试的每个字母都是某个操作的前向映射或所返回的逆元;尊重性会沿任一字母保持R,使到达的值保持相关,并使每个字母的结果相等。因此每个测试在v与v′处一致。□
仅将全文的 = 替换为 ≃ 仍不足够,因为效应函数返回的既有状态,也有逆元;而由 ≃ 识别的两个状态还必须产生由 ≃ 识别的逆元。
定义 36. 映射 f : Γ → Γ 尊重 ≃,若:
两个映射相关,若它们在每个状态处一致; 中的两个函数对相关,若二者两个分量均相关:
尊重 的映射会下降到 ;由 相关的两个映射会下降为该商上的同一映射。效应函数需要二者:前者保证其计算出的状态由商确定,后者保证其返回的逆元由商确定。
定义 37. 将定义 8 按 解读:若 作为映射 尊重 ,并且记 时,对每个 有:
- ;
- 尊重 ,
则称 属于 。取 为 上的相等关系,即恢复定义 8。
引理 38. 按定义 37 解读 时,第 3.1 节断言的每个状态相等,在将 替换为 后均成立;且从 可达的每个状态的累加器都尊重 。
**证明。**累加器是逆元的复合,而每个逆元由定义 37(2) 都尊重 ;尊重 的映射之复合同样尊重 ,基例为 。随后第 3.1 节的证明保持不变:尊重性正是把关系穿过逆元所需的性质。例如由 和 ,尊重性给出 ;这是每次逆元复合所用的一步。定理 7 的健全性不变量则按该步骤读为 。□
定义 19 所要求的交换性可由同一引理按 解读;也正是如此解读,才使该性质可达到:两个操作可以留下由 识别的值,并仍被视作交换。相较于操作提升所诱导的效应函数,两个操作之间还多要求一件事:操作也会产生结果。
定义 39. 当两个操作 a 与 a′ 在每对参数下的提升都作为效应函数独立(定义 19),且一方的变换不扰动另一方产生的结果时,称二者独立:
并对交换 a 与 a′ 后的情形同样要求成立。这里 M(aΣ) 表示所有参数下提升 aΣ(x) 的变换幺半群,正如定义 34 用 \mathfrak{M}(a) 表示操作自身的变换幺半群。若键 k 的任意两个操作 A_k 都独立(也要求一个操作与自身独立),则称 k 是可交换的。
对不同键,条件自动成立。
定理 40. 位于不同键的操作彼此独立。
**证明。**令 a ∈ A_k、a′ ∈ A_k′ 且 k ≠ k′。由定义 24,M(aΣ) 的每个生成元都形如 σ ↦ σ[k ↦ u(σ(k))],其中 u 是 V_k 上的映射,可能是某个前向映射的提升,也可能是某个返回逆元的提升;a′ 在 k′ 处同理。两个这样的映射交换,因为每个只读写一个键,且两个键不同;引理 18(1) 将该交换性从生成元扩展到两个幺半群。对第二个条件,aΣ 在 σ 处产生的逆元与结果均由 σ(k) 决定,而 M(a′Σ) 的每个生成元都保持 σ(k) 不变。□
若某个键的值是一张独立增删条目的表,则它可交换;路由注册或事件监听器注册是代表性例子:两项注册无论以何顺序执行,都会留下对每个测试而言等价的表,且任一注册均可在另一注册仍存在时被撤回。若某个键的值是有序链,则它不可交换,因为在另一个中间件之前插入的中间件会看到不同请求,且任一顺序都无法在不扰动另一方的情况下撤回。开头例子中的分配器按其接口发布的内容而定。若它交出的句柄不会被该键的任何操作比较,则 ≃_k 可在句柄重命名意义上关联两个堆,正如 CompCert 关联程序及其翻译的内存状态 [42] 那样,此时分配可交换;若地址作为结果按相等比较,则不存在可采纳的 ≃_k 能让两种分配顺序一致,该键不可交换。
组件所执行的是一个操作序列,其中每个操作都可能依赖前面操作产生的结果;下面定理讨论的正是这种形状的效应函数。
定义 41. 由余效应中介的效应函数构成最小集合 E^A_Σ ⊆ EΣ,它包含单位元 ηΣ,并在下列构造下封闭:给定键 k、操作 a ∈ A_k、参数 x : X_a,以及一族成员 (e_b)_{b∈B_a},
仍为成员。每个阶段执行一个操作,并根据结果选择后续内容,因此参数可依赖此前获得的结果。一个成员中“出现”的操作,是它在所有结果选择下各阶段执行的操作。
定理 42. 令 e₁, e₂ ∈ E^A_Σ,并设二者都出现操作的每个键都是可交换的(定义 39)。则 e₁ 与 e₂ 独立(定义 19)。
**证明。**对定义 41 的构造归纳可得,M(eᵢ) 位于由 eᵢ 中出现的操作生成元所生成的子幺半群中:单位元生成平凡幺半群;一个阶段是 aΣ(x) 与某个成员的 ⋄ 复合,可应用引理 18(2)。
对于定义 19 的子句 (1),由引理 18(1),只需证明 e₁ 中某个操作的生成元与 e₂ 中某个操作的生成元交换。若两个操作位于不同键,则由定理 40 成立;若位于同一键,则该键承载二者的操作,并由假设可交换。
对于子句 (2),取 g ∈ M(e₂),它是 e₂ 中出现操作的生成元复合;再对 e₁ 的构造归纳。单位元在每个状态返回 idΣ。在一个阶段中,设 (δ, s, b) = aΣ(x)(σ)、(ε, t) = e_b(δ),所以该阶段在 σ 处返回 s ∘ t。对 g 的一个生成元逐一应用操作独立性,可知在 g(σ) 处仍得到 s 和 b,因此选择同一延续 e_b;子句 (1) 将其运行起点放在 g(δ),归纳假设给出同一 t。故该阶段在 g(σ) 处也返回 s ∘ t。□
组件与环境之间的每次交互都通过上下文发生,而类型族 V 不受约束,因此系统可将其在组件间共享的每个位置都绑定到自己的键上(第 3.3.1 节)。于是组件的效应函数就是某个由余效应中介的函数沿余效应投影的提升,而独立性会传递到该提升,因为其变换只移动投影。第 3.1.3 节留下的假设由此得到满足,并随之得到整个组件系统的时间可组合性。
这种分解把计算的可交换部分与顺序敏感部分分开。可交换部分由效应承载:组件按其任务所需的任何顺序执行它们,推论 21 则允许系统按其方便的任何顺序撤销它们,组件之间互不约束。顺序敏感部分由余效应承载,因为操作不可交换的键,其顺序必须在效应之外施加;可施加顺序的位置有两个。在一个组件内部,由累加器施加顺序,无论效应如何都按 LIFO 撤销(定理 16)。在组件之间,由声明的余效应施加顺序:一个组件提供另一个组件声明的内容,而该提供先于声明得到满足(第 3.2.2 节)。由此,可组合性在组件粒度上成立,而非只在单个效应粒度上成立;第 4 节正是在这一尺度上展开。
该定理有两个值得指出的边界。第一,将每个共享位置绑定到键上是该范式的纪律,而非构造自身的性质;因此,系统无法实体化为余效应的位置位于第 6.1 节的边界之外,也位于该定理之外。第二,键的可交换性是该键发布的接口的性质;满足它是提供该键的组件的义务,而非消费该键的组件的义务。
3.3.3. 上下文范式的定位
编程范式在处理副作用的方式上有根本差异。两个既有极点界定了这一谱系:
**显式状态穿行(函数式)。**为保持引用透明性,纯函数式语言把副作用建模为对状态的显式变换。State 单子 S → (A, S) [23] 让环境穿过每个计算。该方法提供强组合保证:效应在类型中可见,并可接受等式推理。然而,它带来显著的易用性成本:调用链中的每个函数都必须接受并返回状态参数,即便它只是原样传递状态。随着效应维度增加(日志、配置、I/O),单子堆叠或效应处理器样板代码会迅速增多。
**隐式变更(命令式/OOP)。**主流命令式语言允许组件修改共享状态,并在调用点不显式声明的情况下访问依赖。在效应侧,代表性例子是 React 的 useEffect 钩子:它在组件内部 fiber 上注册持久副作用,但无论效应目标还是注册机制都不作为显式参数出现,识别依赖于隐藏运行时状态中的调用顺序位置。在余效应侧,Java 的服务定位器模式(例如 Spring 的 ApplicationContext.getBean(...))会在运行时从进程级注册表(registry)取回依赖,并要求每个调用点进行空值检查和类型转换;依赖关系是隐式的,散布于代码库。更一般地,要理解 f() 如何修改系统或依赖系统,就必须传递性地阅读其实现。重构因此变得脆弱,因为移动或删除一个调用可能悄然破坏远处的不变量。
上下文范式结合了函数式方法的可追踪性与命令式方法的易用性。效应和余效应均通过显式上下文参数中介。因此,每个操作都可归因于其所调用的特定上下文,也就可归因于该上下文所属的组件。
在结合两端优点之外,上下文范式还允许开发者逐个处理每个效应与依赖,并自动将它们组合为系统行为。对于可逆效应,开发者只需提供每个原子操作的逆元,任意复合的逆元随复合自动得到(第 3.1 节),因此组件的拆卸由其加载过程导出,而不是另写一遍。对于反应式余效应,组件只声明所需依赖,运行时则自动解析并重新连线(第 3.2 节),在提供者被加入、移除或替换时保持一致连接。在两个方向上,原本需要依赖开发者纪律才能保证的正确性,成为该范式的结构性性质。
4. 动态组合演算
第 3 节只建立了空间可组合性和时间可组合性的局部形式。要将二者推广到整个系统,需要把系统分解为组件;每个组件都把余效应规约与带见证的效应函数配对,使其与共享环境的每次交互都可归因于某个组件。下文为这种分解给出操作语义,并建立空间可组合性和时间可组合性的全局形式。
第 4.1 节和第 4.2 节给出可为生命周期制定规则的最小演算:其中每个转移都被视为原子、即时且不会失败。第 4.3 节逐一放弃这三个假设:对一个转移可能运行的每个方向分别放弃原子性,引入运行时在转移开始和结束之间插入的控制流形式,并最终得到真实运行时所实现的演算。第 4.4 节建立该演算的元理论,包括保持性、全局时间与空间可组合性、进展性和合流性。
4.1. 组件与纤程
本节固定规则作用的对象:组件;纤程,即携带自身生命周期状态的组件实例;以及注册表,它保存状态中携带的纤程,并由此读出余效应上下文。
**组件。**组件被表示为一个三元组,其余效应侧分为从环境读取的内容和向环境提供的内容。
定义 43. 在同时承载效应与余效应的上下文 Γ(定义 32)上,一个组件定义为:
表示三元组 (d, p, e),其中:
- 是定义 25 的余效应规约,声明从环境所需的依赖;
- 是提供项,声明该组件可能提供的余效应键,且 之外没有任何键会被其效应函数写入;
- 是定义 8 的带见证效应函数,定义组件处于活动状态时贡献的效应,以及撤回这些效应的逆元。
两项声明是同一接口的两个方向: 是组件从环境读取的内容, 是组件写入环境的内容。第 4.2 节不允许同一注册表中两个纤程的提供项相交。全文下标均取在 上;余效应上下文是其投影之一(定义 32),所以定义 25 中的 在此写为 。
提供项互斥是本章与第 3.2.3 节分离之处。定义 28 的隔离允许一个键通过 realm 表解析,使两个纤程可以在不同 realm 中提供同一键;若演算携带 realm,则互斥性可放宽为 realm 内互斥,并会根据声明该键的纤程之 realm 解析声明键。本文在此不引入 realm,而是把所有键都解读为位于一个共享 realm 中;这使上述互斥性成为正确条件,并使每个键的提供者唯一(定义 45)。它限制的是一个组件可被实例化的次数:提供项非空的组件同一时间只能有一个纤程。因此,下文的多次实例化主要对应于不提供任何内容的组件,这是只消费或注册其他组件的常见情形。
运行系统中的组件实例会随时间被激活和停用,因此携带生命周期状态;转移则把它从一个生命周期状态移动到另一个:激活执行 e,在上下文上累积副作用;停用施加累加器以恢复上下文。最简单形式是图 1 的二状态模型,第 4.2 节给出其规则;第 4.3 节则随着每种控制流特性的加入而细化该模型。
图 1 | 基础组件生命周期
纤程。一个组件可以被实例化多次,每个实例携带自身生命周期状态。我们称这样的实例为纤程。纤程记录产生它的组件、其被实例化所在的父纤程、其提供的余效应,以及其生命周期位置。
定义 44. 固定纤程名集合 。实例化组件 的纤程为元组 ,其中:
- 、 和 分别是定义 43 中的余效应规约、提供项和效应函数;
- 是父项,即该纤程被实例化所在的纤程,或根标记 ;
σ : Σ是该纤程自身的余效应表(定义 22),在激活前为空,并在其效应运行时被写入;τ : {⊥, ⊤}是退休标志,新纤程中为⊥,一旦编排器使该纤程退休则为⊤;θ : ΘΓ是生命周期状态;在第 4.2 节的二状态模型中为
其中 g : Γ → Γ 是累加器,ω : d → N 是已提交视图。
已提交视图 ω 将纤程声明的每个键映射到转移提交时提供该键的纤程名称。第 4.3 节会用“进行中转移”所需的扩展替换 ΘΓ;定义 44 的其余部分对二者一次性给出,只是 e 会按第 4.3 节各层引入的更丰富效应类型来解读。
**注册表。**状态把纤程按名称保存;纤程身份以及第 3.2 节的余效应上下文都从这一安排读出。
定义 45. 记 为 上纤程集合。状态 携带注册表:
这是有限偏函数,其父指针形成一棵以 为根的树,同时还携带 中未被任何纤程的 命名的其他内容。记 为 ;当状态明确时,用下标缩写 的字段,例如 分别为定义 44 的字段, 为 携带的累加器和已提交视图;、 与 分别表示仅在一个字段、一个纤程、一个纤程存在性上不同的状态。
纤程名称赋予纤程一种能穿过自身变更而保持的身份:下文每条规则都重写一个纤程的生命周期状态,并让其他纤程保持不变,因此规则必须指明是哪一个纤程。两个字段引用纤程而非描述纤程:父项 π 和已提交视图 ω。名称是原子:没有规则计算名称、检查其结构,或以相等之外的方式关联两个名称;引入纤程只是抽取一个尚未使用的名称。这是动态创建局部名称的纪律 [39],在此用于纤程身份。
每个纤程拥有自己的表,意味着余效应上下文是派生出的,而非直接存储的:它就是活动纤程共同提供的内容。
该并集良好定义,因为纤程只写它声明的键,;且不同纤程的提供项互斥(定义 43),所以每个 都恰好位于一个 Active 纤程的表中,其名称记为 ,称为 k 的提供者。因此,每个键只有一个可能提供者,该提供者由提供项固定,而非由状态固定。没有规则直接写 σ_n:纤程的提供项是其自身效应函数执行的 set 操作集合,这些操作落入 σ_n,并已经是 e_n 返回状态的一部分,随后又随累加器离开。只有效应的余效应部分以这种方式被记录,因为只有余效应部分是其他纤程可声明依赖的内容;修改 γ 中其他状态的效应同样由 g 追踪,但没有纤程能在规约中命名它们,因此它们不贡献排序约束。
随后可原样应用第 3.2.2 节的满足性关系,并用 缩写 。一个键位于 中,当且仅当某个 纤程安装了它;提供项表示纤程可能安装的键,而非已经安装的键,所以 已经要求每个声明键都具有一个 提供者。只对 纤程取并集,使纤程可在尚未撤回任何内容前停止提供;第 4.3.1 节会将此转化为排序纪律。
4.2. 基础演算
本节只给出图 1 二状态生命周期的演算:每个纤程用以比较的目标,以及移动它的五条规则。
**目标视图。**规则将每个纤程与一个目标比较,即它是否应当运行,以及应依据哪种依赖解析运行。目标不是纤程自身的属性,因为纤程声明的键是相对于整个状态解析的;因此目标是该状态上的谓词。
定义 46. n 在 γ 处的目标视图将每个声明键映射到其提供者,因此是全映射 ;若 n 根本不应运行,则为 :
若每个纤程都已到达其目标视图,则状态静止:
目标只响应两件事:通过 响应退休,通过 和 provider_k 响应余效应解析;每个声明键都按定义 43 的单一共享 realm 从 读出。
定义 44 的已提交视图与目标视图类型相同,生命周期由比较二者驱动:ω_n 是 n 激活时所依据的解析,target_n(γ) 是它现在应依据的解析;下列每条规则都在二者相同或不同的条件下触发。记录提供者而非值,使比较可用;否则不同纤程提供相等值会被比较为相等。组件读取的值通过视图到达,因为提供者的表保存该值;实现中将该映射保存在 fiber.committed 中,并将其哈希保存在 fiber.target 中(第 5.1.3 节)。
**规则。**基础演算认为每个转移都是原子的、即时的、不会失败的:一次激活在一步中应用其效应函数,一次停用在一步中应用累加器,二者都成功。第 4.3 节会放弃这三个假设。
五条规则生成两种关系。前缀为 O- 的编排规则写作 γ ⇒ δ,表示编排器可执行的动作;其前提说明动作何时合法,而非何时发生。前缀为 L- 的生命周期规则写作 γ ⟶ δ,表示系统在前提成立时自动采取的步骤。步骤序列会交错二者;下文 表示仅由生命周期步骤构成。
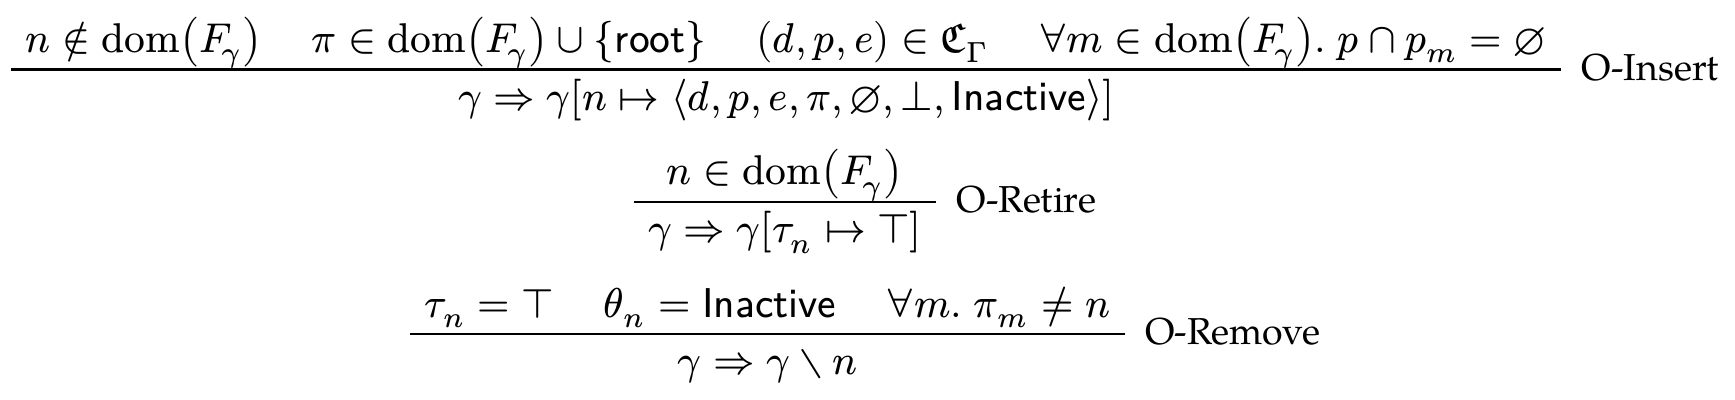
插入与退休是仅有的外部输入:编排器请求某个纤程存在或停止存在,但绝不直接设置其生命周期状态。O-Retire 不以纤程状态为条件,因为退休是一项请求,生命周期规则负责执行它。退休与移除分离也是同一原因:已退休但仍处于 的纤程必须先被停用;过早移除会丢弃累加器并造成泄漏。前提 通过先移除子项再移除父项来保持树良构。O-Insert 的最后一个前提施加单源纪律:编排器不可接纳声明同一键的第二个组件,因此一个键只有一个可能提供者。
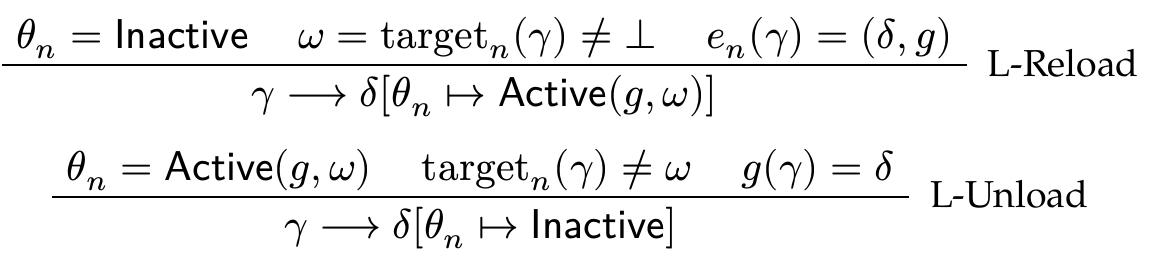
L-Reload 在安装逆元的同时安装已提交视图;L-Unload 施加逆元并丢弃已提交视图。二者由同一比较驱动:当纤程没有已提交视图且目标视图不是 时触发 L-Reload;当其持有的已提交视图不是其目标视图时触发 L-Unload。这是第 3.2 节的反应式纪律,只是目标同时响应退休与余效应:只要目标视图改变,无论由二者中哪一个引起,转移都会启动。
**实例化。**组件可以在安装自身效应时实例化另一个组件,这正是插件宿主在一个插件加载自己的插件时所做的事。到目前为止,规则只允许编排规则操作注册表,因此此类实例化无处发生。一个原语为它提供位置。
定义 47. 的一次应用(或第 4.3.2 节中的某次迭代)可以注册组件 。它不采用一个状态映射,而是执行该组件在 下的 O-Insert,并以所注册纤程的 O-Retire 作为逆元。规则抽取名称,受 O-Insert 的新鲜性前提约束,并把该名称交给效应函数。
逆元执行退休而非移除,原因是逆元必须能在它到达的任何位置应用。O-Remove 带有前提,因此由它构造的逆元可能失败:若父项的子项仍 ,父项无法运行其累加器,且没有规则会移动子项,因为定义 46 不读取纤程树。O-Retire 的唯一前提是 。它在注册发生处留下的条目是已退休、 且持有空表的条目,即引理 57 中的残留条目:它只在控制字段上不同于纤程不存在的状态,没有规则能区分二者。
退休子项会设置 τ,从而把其目标视图变为 ⊥;之后普通规则将其带回 Inactive。父项不会被迫等待,因为 O-Retire 无条件,因此无论子项是否已经离开,L-Unload 都可作用于父项。孙项逐层到达:子项自身的累加器会退休子项注册的内容。定理 66 同时覆盖这种级联,以及第 4.3.1 节沿余效应施加的级联。
**限域。**有了这一例外后,可以给出效应函数所受的纪律。它限制一次应用可写入的内容,使应用规则能解释每个其他变化;也限制一次应用可读取的内容,使纤程只能看到自己声明的余效应以及注册表中不更多的内容。限制写入,正是第 4.4 节可将表 1 解读为完整写入清单的原因。
定义 48. 若对每个满足 的 ,记 ,并满足以下条件,则映射 限域于 :
- 写入。;对每个 且 ,有 ; 与 仅在 上不同。
- **读取。**若两个状态在 、每个 上对 的限制 、以及没有被任何纤程表命名的状态部分上相同,则 将它们带到仍在这三项上相同的状态。
效应函数 限域于 ,当且仅当其每次应用,以及第 4.3.2 节适用时的每次迭代,要么注册一个组件(定义 47),要么其状态映射 与它返回的逆元都限域于 。要求每个纤程的效应函数均限域于该纤程。
一次注册写入 O-Insert 所写的条目,位于其抽取的唯一名称上,除此之外不写任何内容;它返回的 O-Retire 作为逆元,只写该名称的 τ,除此之外不写任何内容。因此,任一类型的应用都不会写入已存在纤程的控制字段,除那个 τ 外;也不会读取任何控制字段。
子句 (2) 说明了组件为什么可以读取自己声明的值:这些值位于其提供者表中,所以若效应函数只能读取 σ_n 而不能读取其他表,就无法使用自身余效应。它不能读取的是 d_n 之外的表,也不能读取任何控制字段;这防止组件基于未声明纤程的生命周期状态进行分支。
这些规则是非确定性的:多个纤程可能持有与其目标视图不同的已提交视图,而关系不承诺它们之间的顺序。规则也是纯反应式的,因为没有任何规则提及调度器;步骤可以是任意规则应用序列,因此针对所有此类序列证明的定理适用于运行时可能采用的任何调度策略。
4.3. 进行中的转移
本节在四种设置中扩展基础演算。第一种补足第 3.2 节所需而第 4.2 节无法表达的内容:一次停用可分布在一段时间区间上,而其依赖方可占据这一区间。其他三种分别放弃“转移是原子的、即时的、不会失败的”这三个理想化假设;真实运行时中的转移都不满足这些假设。被放弃的是“整个转移就是一步”,而非“一步就是一条规则的应用”。四者共享一个结构性后果,在此统一处理:不是一步的转移需要在进行期间占据某个状态,且每个可能运行方向都需要一个状态。
定义 49. 本节生命周期状态将 ΘΓ 替换为:
其中 是剩余效应迭代器(见下文定义 51), 是目前构建的累加器, 是已提交视图, 是结果;它在 中表示停用所朝向的结果,在 中表示已经到达的结果,可能是 ,也可能是第 4.3.4 节提供的错误集合 中的错误。
当纤程处于三个携带累加器和已提交视图的状态之一时,它是已安装的;当它携带错误结果时,它是失败的:
已安装纤程 n 在 时将 k 解析到 m。定义 46 的静止性在更宽的状态空间中解读为:
第 4.1 节的定义延续到该状态空间,但需固定两种读法。第一,第 4.2 节的 在 O-Insert 结论中读为 Inactive(⊥),在 O-Remove 前提中读为 Inactive(-)。第二, 仍只对 Active 纤程的表取并集,因此无论哪个方向的转移正在进行,纤程都通过其持有的 ω 读取余效应,且不提供自身内容;所以,一个转移已经写入的键还不是依赖方可据以激活的键。在二状态演算中,该区别为空,因为其中每个已安装纤程都是 Active。
图 2 展示这些状态构成的生命周期;以下四个小节给出其边上的规则。
图 2 | 带有进行中转移的生命周期;两个转移状态为 Reloading 与 Unloading
4.3.1. 撤回
第 3.2 节要求:依赖方在其依赖之后激活,依赖则只在其依赖方已经停用之后撤回提供项。第一半在基础演算中已成立:一次激活要求 ,所以声明 k 的纤程不能早于某个正在活动且提供 k 的纤程而激活。第二半才是实质问题,而且它必须提供的不只是状态变更排序。一个因其提供者即将离开而被拆卸的组件,正在运行自己的拆卸代码,该代码可能正需要即将被撤回的余效应;例如关闭连接池通常意味着把连接交回提供连接的一方。第二半必须保证消费者在自身停用全过程中仍能读取 k,并且提供者撤回 k 的效果只能在这之后发生。基础演算完全无法保证这一点:其 L-Unload 同时移除提供项并运行逆元,没有在两者之间留下供消费者拆卸占据的区间。
这一层将该步骤拆为两半,并以下列条件守卫第二半。
定义 50. 当某个其他已安装纤程把某个键解析到纤程 n 时,称 n 在 γ 处被依赖:
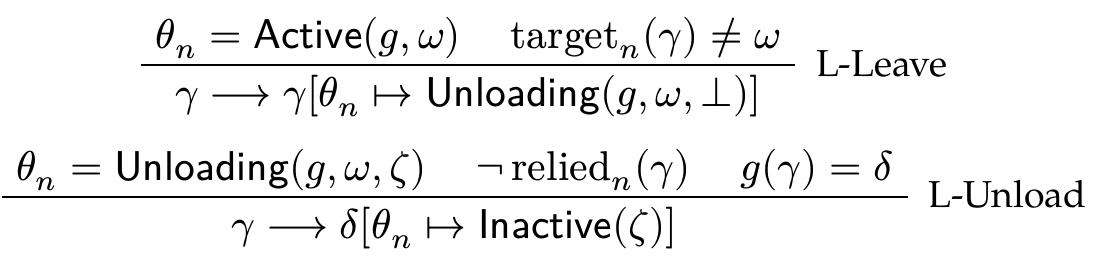
L-Leave 记录停用决定但不立即执行;这会使该纤程停止提供其余效应,同时保留它自己的已提交视图以及其他人的已提交视图。L-Unload 施加累加器、丢弃已提交视图,并让纤程以其携带的结果进入 ;在第 4.3.4 节提供另一种情形前,结果为 ⊥。它是演算中唯一施加累加器的规则。
排序的两半由形式中的不同部分承载:可见性部分由已提交视图承载,L-Unload 在最后一刻才丢弃它;排序部分由前提 ¬ relied_n(γ) 承载,我们称之为守卫,它会推迟 k 的撤回,直到每个把它解析到 n 的消费者都已离开。定理 63 将建立两者。
该守卫按绑定而非按纤程施加:relied_n(γ) 测试是否存在某个已提交视图命名 n,所以没有声明 n 的任何键的纤程不会构成障碍,在另一个 realm 中解析到 n 的某个键的纤程也不会构成障碍(第 3.2.3 节)。在第 4.2 节的单源纪律下,按绑定的读法与较粗的测试 ∃m ≠ n, k ∈ d_m. installed_m(γ) ∧ k ∈ p_n 重合,因为一个键在那里只有一个可能提供者。
这种守卫通常会导致死锁。避免死锁的是 Unloading 与 只对 Active 纤程取并集这两点:一旦 L-Leave 标记了 n,其表就离开 ,所以目标视图不再能命名 n,每个已提交到 n 的消费者自身也正在离开。定理 66 将把这点表述为守卫总会释放。
该守卫沿余效应而非纤程树对停用排序:父纤程可以在其子纤程仍处于 Unloading 时运行逆元,因为 relied 只讨论已提交视图。因此,父子之间的排序弱于定理 63 对提供者与消费者的排序;若父项与子项的效应在环境状态中相遇,则它们受定义 60 的独立性假设约束。
4.3.2. 迭代
一次激活可以按序执行多个效应,停用则必须恢复这些效应。我们用效应迭代器建模此类激活;其每次迭代都会产生修改后的上下文、逆元和延续。
定义 51. 将效应迭代器 与带见证效应迭代器 定义为如下递归类型:
其中 e(γ) 产生三元组 (δ, g, o),表示:
δ是新的上下文;g是当前效应的逆函数;o表示延续:Nothing表示迭代终止,Just(i)提供下一次迭代。
见证按定义 33 的 解读,正如定义 37 解读 的见证:当 尊重 ,且它返回的每个 均尊重 并满足上面的子句时, 属于 。三元组逐分量比较; 只与 比较, 与 在 时比较;迭代器上的 是满足这些子句的最大关系。取 为 上相等时,即恢复字面读法。
效应迭代器变换 通过递归调用把 扩展到迭代器结构。
定义 52. 定义效应迭代器变换 :
每次迭代都会把逆元 按应用顺序复合到 上,因此累加器 在被应用时自然以 LIFO 顺序恢复效应。由于 与 一样落在 中,迭代器本身就是一种效应,可在任何需要效应的位置使用。组件的整个激活就是这样一次使用,这正是本节余下部分将形式化的内容;实现则允许每个变更点都有一个迭代器(第 5.1.1 节)。 延续让任意两次连续迭代之间存在边界,此时上下文就是迭代至今产生的内容,累加器只恢复这些内容。在此意义上,效应迭代器是一种实体化的受界定延续,即主流语言通过 yield 操作符 [43] 暴露的结构,因此该模型可直接映射到它们已经提供的生成器上。
在演算中,自此之后定义 44 的 按 解读;用迭代器替换原子效应函数,会把基础 L-Reload 分裂为轨迹经过的开始状态,并为纤程提供离开该状态的第二种方式。
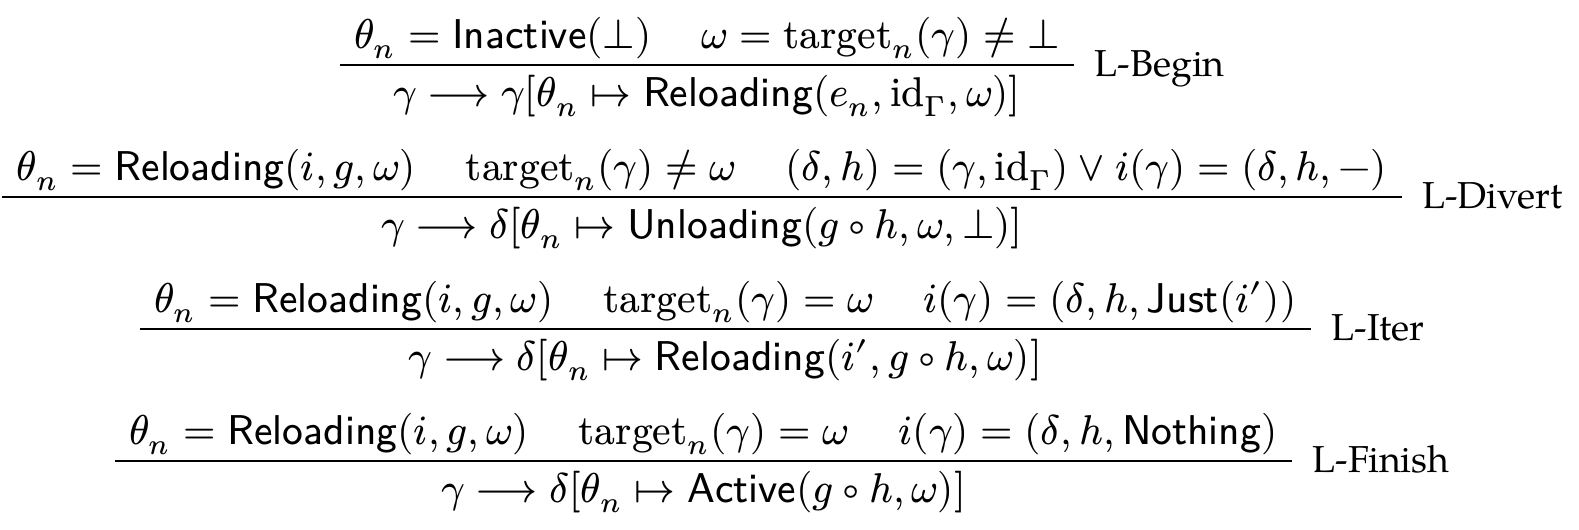
每次迭代都按 将新返回的逆元复合到累加器上,遵循定义 52,使累加器以 LIFO 顺序施加逆元。在任意两次连续迭代之间,若目标视图已经改变,系统可以中途转向该转移,并应用目前累积的逆元来恢复上下文。L-Divert 像所有其他停用一样经由 Unloading,而不是在原地施加累加器;它在那里遇到的守卫是空的,因为从未进入 Active 的纤程不提供任何内容,也不会出现在任何已提交视图中。其两个备选中的第一个会中止纤程持有的迭代,而这只有在迭代边界才可能,因此转向可落下的粒度就是迭代器的粒度;第二个允许该迭代落地,第 4.3.3 节会说明为什么需要它。
普通效应函数()是退化情形:第一次迭代已经返回 。这样的转移仍会经过 ,L-Divert 也仍可应用,但累加器是 且尚未运行任何迭代,所以没有内容需要恢复;该转移要么安装其全部效应,要么一个也不安装。
4.3.3. 异步
到目前为止的层允许环境在两次迭代之间移动,并假定每次迭代本身即时完成,即启动与落地属于同一步。我们抽象地建模非即时性:一次迭代返回类型 Future(A) 的值,其中 Future 是不透明类型构造子,其定义性属性是:在提交与解析之间,外部状态可能改变。
在此模型下,一次迭代在一个状态启动,在另一个状态落地;期间纤程处于 Reloading。这一层增加的是惯性:一旦启动,迭代必然落地,且其落地不能被拒绝。因此,飞行期间发生变化的目标视图无法通过中止迭代来响应,只剩 L-Divert 的“落地一个迭代”备选可用:迭代先落地,纤程随后停用。因此,该层不添加规则,也不添加规则匹配的类型;在 Γ 粒度上,惯性就是其全部内容,并表现为宿主可选择 L-Divert 哪个备选的限制。
这一备选是基础演算无法表达的。在基础演算中,目标视图已转向的转移会在发现这一点的同一步撤销;而在此,飞行中的迭代必须先落地,所以纤程需要一个位置来等待其逆元运行,唯一健全的位置是携带该迭代所产生逆元的 Unloading。若改为经由 Active,纤程会在一步的时间内提供其余效应,并迫使其依赖方对一个已经正在离开的组件激活。这正是实现中 reload 与 unload 的相互链式衔接。
停用也可以不借助单独规则而直接链回激活。L-Unload 对目标视图没有前提,因此无论纤程停用期间目标视图变成什么,累加器都会运行,纤程进入 Inactive;随后 L-Begin 可立即启动新转移。
4.3.4. 失败
此前所有规则都假设其运行的效应成功,而运行时不能如此假设。组件安装的效应会触及追踪上下文之外的事物,而这些事物可能拒绝操作:端口已被绑定、文件不存在、对端无响应。失败的转移仍必须使该纤程的效应被恢复,而不是搁置。
令 Ξ 为错误集合,并细化定义 51 的效应迭代器,使一次迭代可以抛出错误而不是返回三元组:
见证只约束 情形;当模式不匹配时,见证为空,因为一次 raise 没有需要撤销的内容。自此以后, 携带的 按 解读。定义 52 的提升同样延续:raise 会代替三元组被传播,因此抛错迭代器也像普通迭代器一样可用于需要效应的位置。这一层增加一条规则,并使用定义 49 的第二种结果;O-Remove 无需扩展即可接纳它。L-Iter、L-Finish 与 L-Divert 的前提,均按其匹配的三元组外包有 来解读。raise 是迭代所做的事,因此该规则是从 退出。
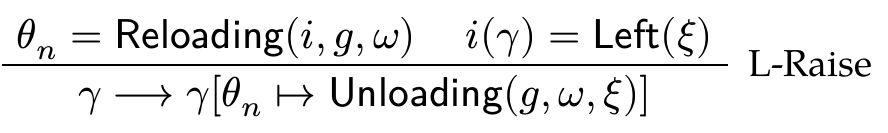
L-Raise 先恢复再记录。纤程携带错误作为结果进入 ;失败迭代之前构建的累加器会在那里被施加;纤程到达 Inactive(ξ) 时没有安装任何内容,其状态与一次中止型 L-Divert 所产生的状态只在纤程携带的结果上不同。像所有其他停用一样路由失败,使每种结果都只能通过 L-Unload 到达;这是定理 59 所依赖的单一事实。L-Begin 的前提是 Inactive(⊥),所以生命周期不会从错误结果重新进入;这是结果的实质含义:它会扣留一个已在所运行状态中表现为不健全的效应函数,而非在未改变环境中重试它。失败纤程也不会阻碍任何事:它是 Inactive,因此不携带已提交视图,不能使 relied 成立。
失败被记录在纤程上,而非向其父项传播,因此某个组件的转移失败会让其兄弟组件继续运行。这是插件宿主所期望的行为,也是结果按纤程记录而非作为整个状态属性的原因。
4.4. 元理论
第 4.3 节给出十条规则:第 4.2 节的三条编排规则;激活用的 L-Begin、L-Iter 和 L-Finish;激活提前结束的两种方式 L-Divert 和 L-Raise;以及停用用的 L-Leave 和 L-Unload。本节从这些规则中读出两种维度可组合性的全局形式:无论其他纤程在中间做什么,单个纤程的保证都成立;并进一步加入只有整个系统才会被要求满足的性质:系统总能到达其目标所要求的配置,且该配置就是静态组装会产生的配置。以下每个性质都是关于步骤序列的性质,因此我们为步骤编号,并从该编号读出状态字段。
两个约定将第 3.3.2 节带入本节。下文所有状态相等均按定义 33 的观测等价 ≃ 解读,正如引理 38 对第 3.1 节所作的解读;效应函数所受的见证条件,是定义 37 给出的条件,并按定义 51 对迭代器、按下文 ≈ 对注册迭代来解读。
定义 53. 用 t 为步骤编号,使 γ_t 为前 t 个步骤到达的状态,并记:
表示在 处采取的步骤:规则 (十条之一)以及该规则作用的名称 。序列从 开始,其中 ,所以每个纤程都通过一次 O-Insert 产生,无论该插入来自编排器还是某次迭代(定义 47)。 的字段以上标携带索引,例如 、、、、 分别为 中 的生命周期状态、已提交视图、表、累加器和剩余迭代器; 和 为 自身的注册表和余效应上下文,即定义 45 的 与 在此状态的读法。谓词以状态为参数,其余内容作下标,因此 、、 和 分别表示定义 46、49、50 在 处的谓词。 的一个片段(episode)是 始终成立的极大索引区间 。它在 打开,其中 且 ,初始空的 保证开始时没有已安装纤程;它在 关闭,当 成立但 不成立时,不过最终片段不必关闭。
第 4.3 节的每条规则结论都形如 γ ⟶ δ[...]:前提从 γ 计算 δ,若没有计算则令其为 γ;方括号则编辑注册表中命名的字段。两半分别命名,且二者都是整个 Γ 上的映射。若某规则在 γ_t 处作用于 n,其状态映射为:
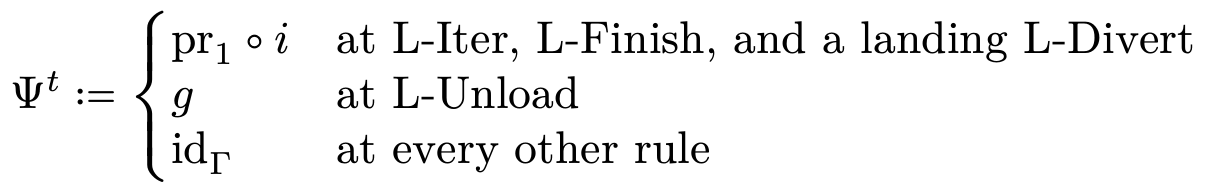
其中 i 与 g 是 θ⁽ᵗ⁾_n 携带的迭代器和累加器;编辑 edit_t : Γ → Γ 是把方括号作为函数来读,将其命名字段赋为前提在 γ_t 处计算出的值。因此,二者均由 step_t 与 γ_t 固定,并在每个状态上定义;这使定理 61 和引理 71 可以在 γ_t 之外对它们求值。每个步骤分解为:
例如在 L-Unload 中, 为 ;在 O-Remove 中,它是移除 ,因此第二半是编辑而非赋值。字段也沿同一分界划分:表 在创建 的 O-Insert 将其置空后,不再被任何 写入;控制字段 及 不被任何 写入,除非经由定义 47 的原语。记 表示两个状态除控制字段外完全一致。
关系 ≈ 不是定义 33 的 ≃,二者互不细化,因为各自遗忘的内容恰是另一方必须保留的内容。恢复精确性是关于效应的主张,所以 ≈ 精确比较表和环境状态,只遗忘“哪个纤程安装了它们”这一注册表记录。规则会读取控制字段以决定是否适用,因此 ≃ 必须保留这些字段;本节将其解读为定义 33 加上注册表定义域及每个纤程每个控制字段的一致:
函数类型字段(如 e_n 及 θ_n 内部的 g)按定义 36 比较映射;迭代器按定义 51 比较;其他类型字段按相等比较。下列结果会同时在两个关系意义下成立,每个关系对应状态的一半;引理 55 会一次性建立全部十条规则的 ≃ 部分。
表 1 将第 4.3 节的十条规则解读为写入。累加器、已提交视图和剩余迭代器都是 的组成部分,所以第三列也记录对它们的写入;该处 表示第四列中迭代返回的逆元,在 L-Divert 中止该迭代时为 。若由迭代器构造出的 注册了纤程(定义 47),该注册会在其抽取的名称上携带 O-Insert 行中的写入;若某个 L-Unload 的累加器退休了一个纤程,它会携带 O-Retire 行中的写入。下文每个分类讨论都是对该表的查找,其中有五类查找反复出现,值得命名。
表 1 | 将规则视为对其作用纤程 n 的写入。
| 规则 | 编辑的控制字段 | |||
|---|---|---|---|---|
| O-Insert | ||||
| O-Retire | ||||
| O-Remove | ||||
| L-Begin | ||||
| L-Iter | ||||
| L-Finish | ||||
| L-Divert | ||||
| L-Raise | ||||
| L-Leave | ||||
| L-Unload |
引理 54. 将表 1 与定义 48 一起解读,对每个步骤 t 以及在 γ_t 处存在的所有纤程 m,n,有:
σ^{t+1}_m ≠ σ^t_m只会在步骤t作用于m时发生,且该写入位于Ψ_t内部;ω_n只在step_t = L-Begin(n)时产生,只在step_t = L-Unload(n)时消失,因此n的一个片段内ω^t_n恒定;Ψ_t = g^t_n只在step_t = L-Unload(n)时发生,且没有其他步骤会将g_n应用于状态;¬ installed^t_n ∧ installed^{t+1}_n ⇒ step_t = L-Begin(n),且installed^t_n ∧ ¬ installed^{t+1}_n ⇒ step_t = L-Unload(n);π_n, d_n, p_n, e_n随n的条目一起产生,之后不再被写;τ_n单调,只会被 O-Retire 写为⊤。
**证明要点。**令步骤 在 处应用规则 。由定义 53,它分解为 : 只写表 1 第五列命名的字段; 是 、 的某次迭代应用,或由这些迭代返回逆元构成的累加器 。三者均由定义 48 限域于 ,因此 不写除 外的既有纤程字段,外加注册原语添加的条目及其逆元写入的 。两半由此划分全部写入;五个子句只是把该划分读到具体字段上。□
下面三个引理说明规则看不见什么。第一个说明规则只通过上述观察读取状态,因此整个演算可下降到 Γ / ≃。
**引理 55(≃ 不变性)。**若 γ ≃ γ′,则第 4.3 节某条规则在 γ 上作用于 n 当且仅当它在 γ′ 上作用于 n;两次应用到达的状态仍由 ≃ 相关。
**证明要点。**每个前提只读取由 保留的内容:、、父指针、、、、 与 。它们不会以超过 的方式读取 的值。结论中, 赋入的值来自这些前提; 要么是恒等,要么是要求尊重 的迭代,要么是由同样尊重 的逆元构成的累加器。□
**引理 56(等变性)。**令 为双射, 为将注册表改为 、并把所有 或 中出现的名称替换为其像的状态。若 良构,则 也良构;且 将 带到 ,当且仅当 将 带到 。
**证明要点。**规则只通过名称相等读取名称;双射保持所有此类比较。规则写入的名称要么来自前提读出的 π 和 ω,要么通过定义 47 抽取新鲜名称;因此写入与 χ 交换。良构性也只比较名称。□
于是,一个序列及其重命名会按同一顺序执行同一规则,并到达只相差 χ 的状态。下文结果均按这种重命名识别名称选择差异。
**引理 57(残留条目)。**若 τ_n = ⊤、θ_n = Inactive(⊥)、σ_n = ∅,且没有 m 满足 π_m = n,则称 n 在 γ 处为残留。残留条目满足 γ ≈ γ ∖ n。若 n 在 γ 处为残留,则对每条规则和每个 m ≠ n:
- 若该规则在
γ处作用于m,则它也在γ ∖ n处作用于m;两者到达的状态只在n的条目上不同,且该条目仍残留; - 反之,若该规则在
γ ∖ n处作用于m,则也在γ处作用,除非它是抽取名称n或声明p_n中某个键的 O-Insert。
**证明要点。**残留的 n 不对规则作用于 m ≠ n 时读取的任何观察产生贡献:它不是 Active,所以不进入 ;它不是 installed,所以不使 relied_m 成立;也没有父指针命名它。移除它只放宽“名称新鲜”和“提供项不相交”两类 O-Insert 前提。引理 54 保证作用于 m 的规则不写 n 的字段。□
简化生命周期状态及匹配它们的规则会得到子演算,但并非所有结果都在简化下保持。重要情形是去掉第 4.3.1 节:其守卫正是定义 58 子句 (3)、(4) 以及定理 63 所需区间的来源。其他三小节增加的内容可被简化掉而不影响下列结果。
4.4.1. 保持性
定义 45 固定了注册表形状;在进一步证明前,必须先验证规则会保持它。本小节识别出规则保持的不变量,其中第一条是注册表形状,其余条款为后续结果的假设。
定义 58. 当对所有 与 ,以下条件成立时,注册表 良构:
- ;
- ;
- 在 上全定义,且取值于 ;
- 。
子句 (1) 是定义 45 中树形结构逐边读取的结果,它保证父指针落在注册表中。该定义还要求无环;这里不需额外子句,因为被指针命名的纤程总是在命名它的纤程之前注册。
**定理 59(保持性)。**若 F^t 良构,则无论 step_t 应用哪条规则,F^{t+1} 仍良构。γ_{t+1} 处每个子句都由 γ_t 处全部四个子句建立。
**证明要点。**令步骤 t 作用于 n。O-Insert 的前提直接保证新纤程的父指针和提供项互斥;O-Remove 的前提保证没有幸存父指针指向被移除纤程。ω_n 只由 L-Begin 写入,而其前提 target_n ≠ ⊥ 保证它在 d_n 上全定义并指向提供者。注册表缩小时,O-Remove 只能移除未安装纤程;由子句 (4),没有已安装纤程的已提交视图指向它。若某个已安装纤程卸载,L-Unload 的守卫 ¬ relied_n 保证没有其他已安装纤程的 ω 仍命名它;若写入新的 ω,L-Begin 的目标值都来自活动提供者。□
L-Unload 的守卫承载了子句 (3)、(4)。O-Remove 的父指针前提只讨论纤程树;真正防止已提交视图指向已移除纤程的是此前施加的守卫。失败也经由 Unloading,因此错误结果不需重复论证。由此得到基础演算没有的两个事实:O-Remove 释放的名称可由 O-Insert 再次发放,因为没有陈旧已提交视图能命名它;纤程一旦 Inactive,即可移除,无需额外检查是否有人依赖它。
4.4.2. 时间可组合性
局部时间可组合性用一个累加器恢复一个效应序列(第 3.1.3 节)。注册表为每个纤程保存一个累加器,而纤程会交错执行:从 n 把一个逆元复合到 g_n 的时刻,到 g_n 运行的时刻,其他纤程可能已经移动了状态。全局保证断言的是:g_n 在那里仍撤销其原本要撤销的内容;条件是中间步骤与 g_n 交换。
定义 60. 对 ,令 为包含 且对延续封闭的最小迭代器集合;把定义 17 的变换幺半群 按迭代器解读:其生成元为 中每个迭代器的前向映射和返回逆元:
在第 4.3.4 节适用时,三元组外读取 Right;len(i) 表示延续排序链长度的上确界。两个迭代器 i,j 独立,当且仅当它们以定义 19 的意义独立,但变换幺半群按此处定义解读,并把一次迭代的返回内容视为其逆元和延续:
并对 j 对称成立。一个步骤序列两两独立,指该序列曾持有的名称集合 N 上的 (e_n)_{n∈N} 两两独立,名称来自编排器插入的纤程以及迭代注册的纤程。
这种独立性就是迹理论中作为原语的内容:可交换动作生成序列上的等价关系,在该关系下重排相邻独立动作保持终点 [44];引理 71 正是这些规则下的重排结论。第一条件由定理 61 使用;第二条件由定理 73 额外需要,因为重排两个纤程的步骤会在被另一纤程移动后的状态上求值某个迭代器,而映射交换本身并不说明迭代器在那里返回相同逆元和延续。
在这些条件下,定理 7 的单累加器不变量可在交错中存活,并给出时间可组合性的内容:运行一个逆元只撤回该纤程自己的贡献。
**定理 61(恢复精确性)。**设步骤序列两两独立,n 的某个片段在 b 打开,u ≥ b 位于该片段内,并令 t₁ < … < t_l 为 [b,u) 中作用纤程不是 n 的索引。则:
也就是说,在 γ_u 处施加 n 的累加器,会在控制字段之外得到同一组其他步骤从 γ_b 出发所产生的状态。若将右侧理解为“n 从未开始时到达的状态”,还需额外假定 [b,u) 中没有由 n 注册的纤程采取步骤。
**证明要点。**对 归纳。若步骤作用于 ,则 L-Iter、L-Finish 或落地型 L-Divert 会把新逆元 复合进 ;迭代见证给出 ,注册情况用残留条目引理处理。若步骤作用于 ,则 不变,而 或为 ;独立性允许把 与该 交换,于是把该外部步骤追加到右侧复合中。编辑只写控制字段,因此在 下可忽略。□
**推论 62(终端恢复)。**若步骤序列两两独立,且 n 的片段在 b 打开、在 u 关闭,无论 n 到达何种结果,则以上 t₁ < … < t_l 满足:
由 O-Remove 移除的纤程也不会留下内容,因为其前提只允许 θ_n = Inactive(-)。
**证明要点。**由引理 54(4),u 处步骤为 n 的 L-Unload;由引理 54(3),其 Ψ_u 是 g^u_n,因此 γ_{u+1} ≈ g^u_n(γ_u),再应用定理 61。结果 ζ 不出现在命题和 ≈ 中。□
上述结果将两两独立性作为组件假设;第 3.3.2 节负责解除该假设:若组件执行的每个效应都是某个键的操作,且每个键可交换,则由这些操作构造的任意两个效应函数独立(定理 42)。从效应函数推广到迭代器不需新内容,因为由余效应中介的效应函数已经根据每阶段结果选择后续,而这正是迭代器在延续中承载的东西。
4.4.3. 空间可组合性
局部空间可组合性把组件约束于自身规约:只在其依赖被提供时激活,并按依赖分类每次上下文变化(第 3.2.2 节)。全局形式增加了跨纤程量化的内容:提供者只在每个解析到该绑定的依赖方停用后撤回绑定;转移安装效应时依据的解析不会在其下方漂移。余效应侧的两个性质分别给出二者,且二者共同证明,因为它们都是引理 54(2) 所建立的“片段内 ω_n 固定”不变量的两面。
**定理 63(排序)。**纤程只会在其依赖被提供时开始转移:
进一步,设 [b′,u′] 是 m 的一个片段,且对某个 m ≠ n 与 k ∈ d_m 有 ω^{b′}_m(k) = n;设 [b,u] 是包含 b′ 的 n 的片段,并令 t 遍历 [b′,u′]。则:
ω^t_m(k) = n;b < b′,且若[b,u]关闭,则u′ < u;k ∈ dom(σ^t_n),且σ^t_n(k) = σ^{b′}_n(k)。
**证明要点。**第一句直接来自 L-Begin 的 target_m ≠ ⊥ 前提。子句 (1) 由引理 54(2) 的片段内 ω_m 恒定得到。对子句 (2),m 的 L-Begin 将其 ω 写为目标,其中的值是活动提供者,所以 n 早于 m 已经处于 Active;n 若在 m 前关闭,则 m 的已提交视图仍命名 n,使 relied_n 成立并阻止 n 的 L-Unload。子句 (3) 利用 n 在 b′ 是 k 的提供者,以及 [b′,u′] 中 n 不可能 L-Unload;引理 54(1) 保证 σ_n 在此期间恒定。□
分布在多个步骤上的转移否则可能安装基于已经变化的解析计算出的效应;两类前提防止这一点。L-Iter 与 L-Finish 带有 target_n(γ)=ω,所以转移只在其已提交视图仍是目标视图时继续;L-Divert 带有否定条件,因此目标视图的任何变化都会把纤程带出转移。L-Raise 不以目标视图为条件,因为 raise 是迭代本身做出的事,并且无论如何都会退出转移。变化的两个方向不再区分:依赖消失与依赖被替换都使目标视图不等于 ω,并经由同一路径离开。
惯性使这不能成为关于每一步的保证。目标视图转向时已经飞行中的迭代仍会按 L-Divert 落地,而该落地会安装一个按旧解析计算出的效应。因此规则给出的是一个析取;第二分支正是使第一分支安全的内容。
**定理 64(解析一致性)。**令 n 的片段 [b,u] 在 b 打开,且 ω^b_n = ω。则 θ_n 在该片段初始区间 [b,r] 上为 Reloading(-,-,-),且该转移的每次迭代都依据同一解析 ω 运行:
当纤程离开该区间,即 r < u 时,恰有以下两种情形之一成立:
step_r = L-Finish(n),且θ^{r+1}_n = Active(-,ω);step_r ∈ {L-Divert(n), L-Raise(n)},且片段在某个u > r处关闭,并按推论 62 得到相应恢复等式。
证明要点。b-1 处 L-Begin 写入 Reloading,且这是唯一进入该状态的规则;片段内不会再次 L-Begin。因此 Reloading 占据一个初始区间。L-Iter 与 L-Finish 的前提给出 target_n=ω。离开 Reloading 的规则只有 L-Finish、L-Divert 与 L-Raise;前者进入 Active,后两者进入 Unloading,随后唯一出口是 L-Unload,并由推论 62 给出恢复。□
4.4.4. 进展性
将提供者撤回推迟到其依赖方离开之后的守卫,只有在最终会释放时才真正交付定理 63。注册表纤程上的一个关系承载该论证。
定义 65. 注册表名称上的优先关系为:
表示 n 可能提供 m 声明的某个键。该关系只读取 d 和 p,而二者由引理 54(5) 随纤程条目产生后不再被写。
定理 66 与定理 73 在假设 ≺ 无环的条件下建立。无环性是额外假设而非定义保证;若组件声明自己提供的键,则有 n ≺ n。≺ 排序的是两个纤程的激活,而非生命周期:n ≺ m 表示 n 必须先于 m 进入 Active;至于提供者寿命长于消费者,则是定理 63(2) 关于带守卫演算的结论。
纤程的目标视图也响应创建它的纤程。创建者通过定义 47 的原语写入 τ_n,而 τ 由引理 54(5) 单调。因此,创建者在子纤程整个存在期间至多转动一次该子纤程的目标视图。
**定理 66(进展性)。**假设 ≺ 无环,每个 n 都有 len(e_n) ≤ K,定义 60 中的名称集合 N 有限;并且每个步骤都应用生命周期规则。记 S(n) 为作用于 n 的步骤数,且
为其目标视图转动次数。则:
- 无死锁。
¬ quiet^t蕴含某条生命周期规则可在γ_t处应用; - 终止。
S(n) ≤ (K + 4)(V(n)+1),且V(n)与∑_n S(n)均有限。
因此,每个极大的生命周期步骤序列都在静止状态结束。
**证明要点。**若状态非静止,则某个纤程必处于以下可动情形之一:Inactive(⊥) 且目标非 ⊥(可 L-Begin);Reloading 且目标等于已提交视图(根据迭代结果可 L-Iter、L-Finish 或 L-Raise);Reloading 且目标不同(若 raise 则 L-Raise,否则落地型 L-Divert);Active 且目标不同(可 L-Leave)。若剩下的是某个 Unloading 纤程,则沿 relied 构造链;若其守卫不释放,就找到依赖它的另一个已安装纤程。定理 63(3) 使该关系给出 ≺ 上升链;无环性与注册表有限性保证链终止,于是某个 L-Unload 可用。
终止性分两步。其一,在目标视图恒定的任意极大区间上,一个纤程至多经历 K+4 个步骤:至多一次离开旧状态、一次卸载、一次开始、至多 K 次迭代落地,加上失败场景下的第二次卸载。其二,目标视图每次转动要么由某个 ≺ 下方纤程的步骤引起,要么由写入自身 τ_n 引起;后者每个纤程至多一次。由于 ≺ 无环且 N 有限,可用良基递归给出全局有限上界。因此不能无限延伸的序列必然静止。□
N 的有限性是外部假设。实践中,宿主持有的组件是运行前给定的有限程序;若没有组件能直接或间接注册无限个自身实例,注册树深度有界,且 len(e_n) ≤ K 会界定分支数。该假设排除的是可无界注册自身实例的组件。
目标记录提供纤程而非布尔值;在第 4.2 节的单源纪律下,二者驱动同样的转移,因为键只有一个可能提供者。视图提供的是上述结果的表达词汇:定理 63 和定理 64 都讨论纤程激活所依据的解析;它也使结果能够在第 3.2.3 节的作用域化解析下存活,因为在作用域化解析中,同一键可在不同 realm 中解析到不同提供者,提供项不再强制唯一视图。实现中承载该作用域,并把视图保存在 fiber.committed(第 5.1.3 节)。
4.4.5. 合流性
前述结果关注单个纤程。刻画整个系统的性质是:动态历史不留下痕迹。无论运行系统经历怎样的激活与停用序列,它静止时的状态都等于如下静态组装所产生的状态:把最终处于活动状态的每个组件按依赖顺序各加载一次,并且从不卸载。生命周期关系是合流的,其汇聚到的正规形正是静态组装结果。这是动态组合场景中对“从头求值一致性”的类比;后者是增量计算中变化传播所建立的性质 [45]。
该命题只讨论 ⟶。编排步骤是输入;给定不同输入的两个序列落在不同位置没有理论意义。问题在于生命周期规则是否会因非确定选择(下一步移动哪个纤程、Reloading 纤程采取哪个出口)而产生不同结果。
首先需要三个引理。第一个无需参考任何步骤序列即可固定最终 Active 的纤程集合,因此它是输入函数而非调度函数。
定义 67. 若一个纤程未退休,注册它的纤程受支持,并且它声明的每个键都由受支持纤程提供,则称该纤程在 处受支持。 上的支持关系是这两个子句读取关系的并集:
当其良基时(引理 68),记 A 为 γ 中受支持纤程集合:
其中 标记由编排器插入的纤程,否则 是其激活注册 的纤程。子句只读取 。
**引理 68(支持良基)。**若 ≺ 无环且 γ 由某个步骤序列到达,则 ⊲ 良基,且定义 67 的 A 有唯一解,是 τ,π,d,p 的函数。
**证明要点。**按每个名称被注册的步骤索引排序。父指针总是指向更早注册的纤程,因此沿父边下降。若出现环,必须混入 ≺ 边;但这要求某个纤程声明由其自身子树中的纤程提供的键。该子树纤程只能在该纤程激活之后注册,而激活又要求该键已有活动提供者;由提供项互斥,不可能再由子树提供同一键。因此该边不会出现在实际注册表中。良基递归给出唯一解。□
定义 69. 若一个组件完成激活后安装了其提供项中的每个键,即实例化它的每个 Active 纤程都满足 dom(σ_n)=p_n,则称该组件在其提供项上是全的。
与独立性一样,这是组件条件,不涉及生命周期状态或步骤。
**引理 70(静止时的支持)。**设 ≺ 无环,quiet(γ),γ 中没有失败纤程,且每个组件在其提供项上为全。则支持集合等于 Active 纤程集合:
**证明要点。**在无失败且静止的状态中,只有 与 可能出现;静止性给出 活动当且仅当 。定义 46 又将后者展开为: 未退休,且 中每个键都位于 。全性使 。若 是非根注册纤程,且其父不活动,则父的累加器已运行并退休 ;于是 不会活动。故活动集合满足定义 67,唯一性给出结论。□
**引理 71(换位)。**设步骤两两独立且 F^t 良构,步骤 t 与 t+1 分别作用于不同纤程 m,n。
- 若二者都应用激活规则(L-Begin、L-Iter 或 L-Finish),且
step_{t+1}已可在γ_t处应用,则先执行step_{t+1}后step_t也可应用,并且两种顺序到达同一γ_{t+2}。 - 若
step_t在m处应用激活规则,step_{t+1}在n处应用编排规则,且step_t未注册n,则二者同样可交换。
**证明要点。**激活步骤只写自身 及其效应内的 /环境效应;独立性的第二条件保证它不会改变另一个迭代器返回的逆元和延续。 前提不会被破坏,因为提供项互斥保证一个已满足键的提供者唯一,其他纤程写不到该键。状态映射由独立性第一条件交换,编辑写不同纤程控制字段而交换。激活与编排步骤的换位更简单:编排步骤的状态映射为 ,其编辑只写 或 中与 相关的内容,而激活既不读也不写这些内容;新鲜插入只会放宽较小注册表中的前提。□
**引理 72(删除)。**设步骤两两独立,每个组件在其提供项上为全;序列到达无失败的静止状态 γ_T。令 [b,u] 是关闭的 n 片段,且序列中没有任何满足 n ≺ m 的 m 的片段关闭,也没有任何由 n 在 [b,u] 中注册的纤程拥有片段。记 R 为这些注册抽取的名称。删除 [b,u] 中作用于 n 的步骤,以及每个作用于 R 中名称的步骤后,剩余序列仍到达与 γ_T 在 ≈ 下相等、并在 R 之外与其在 ≃ 下相等的状态。
**证明要点。**推论 62 表明该关闭片段对非控制状态无净效应;被删除的 n 步骤只改写 θ_n,并在关闭时恢复为 Inactive(⊥)。n 注册的名称由其累加器退休,因假设没有片段而成为残留条目。后缀通过引理 57 保持:对 R 外纤程的步骤在两侧仍有相同前提和相同效果;作用于 R 名称的步骤必须删除,因为缺失名称不能被 O-Retire 或 O-Remove 操作。删除不会破坏其他前提:若某步骤通过 target 读 n,则要么存在 n ≺ m,而此类 m 的片段按假设不关闭且最终活动,从而不会真依赖该被删片段;要么 m ∈ R,已由删除处理。□
**定理 73(合流性)。**设一个步骤序列到达无失败的静止状态 γ_T;步骤两两独立,且每个组件在其提供项上为全(定义 69);令 A 如定义 67。则:
- **规范形。**从
γ₀出发,可在名称被归约撤回之处取商后到达γ_T:先按原顺序执行同一批编排步骤,其中编排器插入的纤程相关编排步骤位于所有生命周期步骤之前,其余编排步骤位于注册其作用纤程的步骤之后;随后,对A的某个线性化n₁,…,n_k,按该顺序各执行一个片段。 - **合流。**从
γ₀出发、采取同一批编排步骤的任意两个此类序列,经引理 56 的重命名后,到达的状态在≃和≈下相关。
**证明要点。**先反复删除关闭片段:每次选择在 ⊲ 上极大的关闭片段,引理 72 的三个前提由极大性与注册/退休机制保证。删除所有关闭片段后,A 外纤程没有生命周期步骤。然后用引理 71 将编排步骤移到规范位置;由编排器插入的纤程相关步骤可前移,注册产生的纤程相关步骤需留在注册之后。最后按 ⊲ 对活动片段排序并使其连续:取 ⊲ 极小的活动纤程,其依赖为空且父为 root,目标恒定,因此其激活步骤可用引理 71 一步步前移;对剩余集合重复。两个序列最终都化为规范序列;注册产生的名称可能不同,但引理 56 用双射匹配注册树。不同线性化之间只差不可比片段的换位,引理 71 保证终点不变。结合定理 66 的终止性,生命周期关系具有唯一正规形。□
失败被排除在陈述之外,因为它是真正的分歧来源,演算不应否认这一点:某一步是否抛错取决于它运行时面对的状态,因此一种调度可能使某纤程失败,另一种调度可能使其完成,两个静止状态会在该纤程生命周期状态上不同。但由推论 62,它们不会在其他内容上不同,因为失败纤程对状态的贡献为空。
在第 4.2 节的基础演算中,同一定理也成立,证明只需删除一项:那里 L-Unload 不带守卫,所以引理 72 的最后一段为空;其余部分只依赖静止性,而基础演算同样提供该性质。
该定理允许我们像推理静态组装系统那样推理 Cordis 应用。若编排器添加组件、移除组件、替换提供者再撤回该替换,系统保证会到达与一开始就写下最终组合相同的状态;组件作者推理哪些余效应在作用域中时,只需推理静止状态。它也界定了保证边界:它讨论的是状态,而不是系统沿途产生的发射事件。这正是第 6.1 节区分“获取”(在边界内被追踪)与“发射”(跨越边界)的依据。
5. 实现与案例研究
本节介绍 Cordis。它把第 3 节的形式模型实现为一种实用编程抽象。Cordis 是时空可组合性的元框架:不同于面向特定领域的应用框架(例如 Web 路由、ORM、UI 渲染),它不预设具体场景;其唯一职责是提供通用动态组合语义。实现分三层:(1) 核心库(第 5.1 节)直接实现效应与余效应系统;(2) 组件加载器(第 5.2 节)在核心之上扩展配置协调与热模块替换;(3) Koishi 等应用框架(第 5.3 节)在前两层之上构建领域特定功能。
5.1. 核心库
表 2 总结理论构造与运行时对应物。下文使用运行时名称描述实现,理论符号仅用于对应关系说明。记号 @@name 表示框架内部的 symbol 键,因此 ctx[@@store] 中的括号表示以 symbol 键访问上下文的不透明槽位,而非索引字符串键映射。
表 2 | 理论到实现的对应关系
| 理论构造 | 实现对应物 |
|---|---|
ctx,一等上下文 | |
| 上下文树以及运行系统触及的所有内容 | |
| , | 返回/产出逆元的 Effect 回调 |
ctx.effect(callback) | |
| , , | ctx[@@store], ctx[@@isolate], ctx[@@intercept] |
get(k), set(k,v) | ctx.get(key), ctx.set(key, value) |
isolate(k,r) | ctx.isolate(key, realm) |
intercept(k,ν) | ctx.intercept(key, metadata) |
⟨d,p,e,π,σ,τ,θ⟩ | fiber,组件实例 |
通过 ctx.registry 枚举 | |
fiber.uid | |
fiber.inject | |
组件的 provide | |
fiber.apply | |
fiber.parent.fiber.uid,拥有其实例化上下文的纤程 | |
| 派生实现 | fiber.ctx,纤程运行所在的子上下文 |
θ | fiber.state;其中 LOADING 对应 Reloading,FAILED 对应 Inactive(ξ) |
recover / 累加器 g | fiber.dispose |
ω | fiber.committed |
provider_k(γ) | 提供者纤程为 ACTIVE 的 Impl |
target(γ,n) | 由 refresh 重算的 fiber.target,其中 ⊥ 为 INACTIVE |
Future / 惯性 | fiber.inertia,进行中转移的句柄 |
| O-Insert / O-Retire | ctx.use 及其回调逆元(算法 4) |
| O-Remove | 从运行时丢弃纤程,并清除 uid |
| L-Begin / L-Iter / L-Finish | execute 的迭代循环(算法 1) |
| L-Divert | 迭代边界处守卫失败(算法 1),或 reload 链入 unload |
| L-Leave | refresh 将纤程标记为 UNLOADING(第 10 行) |
| L-Unload | unload 及其惯性链式行为(算法 5) |
| L-Unload 守卫 | unload 等待被通知依赖方(第 25 行) |
| L-Raise | 记录在纤程上的错误,并将目标设为 ⊥ |
本节余下部分自底向上构建核心库。第 5.1.1 节实现可逆效应,这是上下文被修改的唯一原语;第 5.1.2 节在其上实现反应式余效应;第 5.1.3 节将二者组合为组件生命周期;第 5.1.4 节暴露建立在这些机制上的上下文级操作。
5.1.1. 效应追踪
本节实现可逆效应(第 3.1 节)。Cordis 中每次上下文变更都通过单一原语 ctx.effect:余效应提供、组件实例化以及其他任何修改上下文的操作都会归约为一次 ctx.effect 调用。因此,所有经由上下文执行的操作都会在组件卸载时被自动追踪并恢复。从操作上看,ctx.effect 是 (定义 52)的实现:它接收类型为 的回调,并将其提升到 ,产出一个 dispose 闭包(closure);调用该闭包时即可恢复该效应。Cordis 通过一个操作同时接收 和 (ad-hoc 多态);本文以迭代器形式为代表,因为普通效应函数只是产出单个逆元的退化迭代器。该操作不会检查 携带的见证:回调负责提供逆元,而该逆元是否确实恢复其伴随效应,是组件作者的义务而非运行时验证的性质。定理 61 中演算会使用这一义务,第 6.1 节则界定该义务边界。
算法 1 效应追踪
1 async function execute(callback, guard)
2   iter ← callback()
3   inverse ← id
4   while guard()
5     (value, done) ← await iter.next()
6     if value then inverse ← value ∘ inverse
7     if done then break
8   return inverse

9 function effect(ctx, callback)
10  armed ← true
11  task ← execute(callback, () ↦ armed)
12  async function dispose()
13    if not armed then return
14    armed ← false
15    recover ← await task
16    recover()
17  ctx.dispose ← dispose ∘ ctx.dispose
18  return dispose
引擎 execute 将回调作为效应迭代器(定义 51 的 )驱动,并把每一步产出的逆元折叠为单一复合。每步前它都会询问调用方提供的守卫;一旦守卫触发,迭代停止,只保留此前累积的逆元。这是第 4.3.2 节的步骤边界中断: 延续由迭代器的 done 标志和 guard 共同实现。
ctx.effect 是 execute 上的一层薄封装,增加两件事。第一,自我释放:守卫报告 armed 标志,返回的 dispose 会把 armed 置为 false;这同时停止任何进行中的迭代,并保证恢复至多触发一次。若触发两次,逆元会在并非由该效应施加产生的状态上应用,无法保证撤销任何内容。第二,父级复合:dispose 会前置到外围上下文的累积逆元 ctx.dispose 上,因此子效应的逆元本身就是父上下文上的效应,这正是 ∂²Γ 的递归结构。组件层(第 5.1.3 节)复用同一个 execute,只是守卫改为测试 fiber.target 是否稳定,而非测试 armed。
5.1.2. 余效应操作
本节实现反应式余效应(第 3.2 节)。所有余效应操作都作用于每个上下文携带的三个 symbol 键槽位:
@@store:值存储σ : (r : R) ⇀ V_r,从 realm symbol 到带类型值;@@isolate:realm 表ρ : Map(K,R),从余效应键到 realm symbol;@@intercept:拦截表ι : (k : K) → M_k,为每个键分配元数据。
前两者组合为两层解析 k → ρ(k) → σ(ρ(k)):ctx.get(key)(算法 2)先从 @@isolate 读取 realm symbol ρ(k),再从 @@store 读取绑定值 σ(ρ(k))。ρ 的间接性使隔离能够把一个键重定向到独立绑定;@@intercept 只在访问绑定时被查询,用于调整绑定的使用方式,而非调整其解析目标。这些操作分两部分实现:(1) 提供与通知,即安装或撤回绑定并传播变化到依赖方;(2) 隔离与拦截,即重塑键的解析方式。
**提供与通知。**由于 set(k,v) 具有类型 EΣ(第 3.1 节),余效应提供就是一次 ctx.effect 调用,并继承其自动追踪与恢复。算法 2 实现具体的 set(k,v):回调在 store 中以 realm symbol ρ(k) 绑定值,返回的 dispose 函数移除该绑定。安装和移除都会调用 notify,将变化传播给依赖组件。
算法 2 余效应操作
1 function get(ctx, key)
2   realm ← ctx[@@isolate][key]
3   return ctx[@@store][realm]

4 function set(ctx, key, value)
5   function callback()
6     realm ← ctx[@@isolate][key]
7     ctx[@@store][realm] ← value
8     notify(ctx, [key])
9     return function()
10      delete ctx[@@store][realm]
11      notify(ctx, [key])
12  return ctx.effect(callback)
算法 3 通过测试每个存活纤程来把绑定变化传播给依赖方:若某个变化键出现在 fiber.inject 中,且解析到同一 realm,则调用 refresh(第 5.1.3 节)依据新状态重新求值该纤程,并返回被重新求值的纤程供调用方等待。这是定义 26 的反应式分类:若变化翻转满足性,则激活或停用纤程;若是中性变化,refresh 的幂等性会使其无害。该重新求值如何与不同控制流交互,将在第 5.1.3 节展开。
算法 3 反应式通知
1 function notify(ctx, keys)
2   affected ← ∅
3   for fiber in all_fibers do
4     for key in keys do
5       if key ∈ fiber.inject and fiber.ctx[@@isolate][key] = ctx[@@isolate][key] then
6         refresh(fiber)
7         affected ← affected ∪ {fiber}
8         break
9   return affected
某个绑定只有在安装它的纤程为 ACTIVE 时才对依赖方可用,因此 refresh 会把每个声明键解析到活动提供者,而不仅仅查询 store。这是定义 46 的 provided-by 关系,它让一次撤回在真正发生之前一个步骤就对依赖方可见:进入 UNLOADING 的提供者已经停止提供,所以其依赖方会重算出不满足的目标视图,并开始自身拆卸,而此时提供者的绑定仍全部存在。
**隔离与拦截。**这两个操作结构上做同一件事:各自派生一个子上下文,调整某个键继承来的表,而不触及父上下文。因此恢复是隐式的:丢弃子上下文即可,无须显式运行逆元。ctx.isolate(key, realm) 会用 realm 覆盖 realm 映射 ρ,若未给出则生成新 symbol(实现定义 29 的 isolate),因此为同一键分配不同 symbol 的两个上下文会解析到独立绑定。ctx.intercept(key, metadata) 会把元数据合并进拦截表 ι(实现定义 31 的 intercept):按照该定义,新元数据与上下文已携带的 key 元数据组合,并优先于后者。
5.1.3. 组件生命周期
组件由 ctx.use 实例化为纤程。本节赋予第 5.1 节引入的纤程以操作意义,即第 4.3.3 节的惯性状态机。下列算法由两个字段驱动:fiber.parent,即形成组件层级的 fiber.ctx 父上下文(第 3.3.1 节的 递归结构);以及 fiber.inertia,即进行中的异步转移句柄(空闲时为 null)。
算法 4 展示组件实例化。组件把余效应规约 component.inject(d)与效应函数 component.apply 配对;实例化时会把组件配置绑定到 fiber.apply(第 9 行),形成生命周期运行的配置化效应函数 e。callback 函数(第 2 行)是在父纤程中被追踪的效应:执行它会通过 refresh(算法 5)启动子纤程生命周期;恢复它则强制子纤程目标为 ⊥ 并触发 unload。这就是定义 47 的注册原语,其中 callback 是 O-Insert,其返回闭包是 O-Retire:实例化是父项的一次普通被追踪效应,因此卸载父项会级联到其子项。
算法 4 组件实例化
1 function use(ctx, component, config)
2   function callback()
3     refresh(fiber)
4     return function()
5       fiber.target ← ⊥
6       unload(fiber)
7   fiber ← Fiber(parent: ctx, inject: component.inject)
8   fiber.ctx ← ctx[fiber ↦ fiber]
9   fiber.apply ← () ↦ component.apply(fiber.ctx, config)
10  ctx.effect(callback)
11  return fiber
算法 5 实现第 4.3.3 节的惯性状态机:reload 与 unload 都具有惯性;一旦进入,转移会运行到完成,再响应目标状态变化。算法使用两个余效应 store 上的辅助查找:resolve(inject) 返回已声明键当前解析到的绑定,provided(fiber) 返回该纤程安装了绑定的键。refresh 会从余效应 store 重算 fiber.target,如果纤程不在转移中,则启动 reload 或 unload 任务。reload 记录当前目标并执行组件效应函数 apply;完成后检查目标是否仍匹配:若匹配,纤程进入 ACTIVE;否则无论新目标是 ⊥ 还是另一组提供者,都链入 unload。对称地,unload 以 LIFO 顺序恢复全部被追踪效应,然后进入 INACTIVE 或链入 reload。这种互递归实现了惯性属性:一旦转移开始,它会在任何新转移开始前完成。
算法 5 组件生命周期
1 function refresh(fiber)
2   target ← target(γ,n)
3   if target = fiber.target then return
4   fiber.target ← target
5   if fiber.inertia then return
6   if target ≠ ⊥ then
7     fiber.state ← LOADING
8     fiber.inertia ← create_task(reload(fiber))
9   else
10    fiber.state ← UNLOADING  ▷ 在调度任何逆元之前退出服务
11    fiber.inertia ← create_task(unload(fiber))

12 async function reload(fiber)
13  target0 ← fiber.target
14  fiber.committed ← resolve(fiber.inject)
15  recover ← await execute(fiber.apply, () ↦ fiber.target = target0)
16  fiber.dispose ← recover ∘ fiber.dispose
17  if fiber.target = target0 then
18    fiber.state ← ACTIVE
19    notify(fiber.ctx, provided(fiber))
20    fiber.inertia ← null
21  else
22    fiber.state ← UNLOADING
23    fiber.inertia ← create_task(unload(fiber))

24 async function unload(fiber)
25  await all(notify(fiber.ctx, provided(fiber)).map(f ↦ f.await()))
26  await fiber.dispose()
27  fiber.dispose ← id
28  fiber.committed ← ⊥
29  if fiber.target = ⊥ then
30    fiber.state ← INACTIVE
31    fiber.inertia ← null
32  else
33    fiber.state ← LOADING
34    fiber.inertia ← create_task(reload(fiber))
fiber.target 通过把每个声明键解析到当前余效应 store,并组装提供它的纤程 uid 来计算,因此它是 target(γ,n)(定义 46)的摘要。用提供者而非值来标识绑定,使一次与记录目标的比较足以判断变化:uid 新鲜抽取且永不复用,因此即使替换提供者提供相等值,也不会被误认为旧提供者。由于 notify(第 5.1.2 节)会在每次余效应变化时重算目标,某个声明键一旦改由不同纤程提供,该纤程就会重载(reload)。提供者原地覆盖自己的绑定则不会被观察到;若组件希望替换传播,就应撤回绑定并重新安装。
算法在两个互补层次上运行。在转移层,reload 与 unload 在完成时检查目标,使跨转移的惯性链式行为成为可能。在每个转移内部的迭代层,效应执行(算法 1)在每个迭代边界检查目标,使单次转移内部的部分回滚成为可能。两种机制分别对应第 4.3.3 节的转移间链式行为,以及定理 64 所依赖的转移内陈旧性检查。
三行代码承载定理 63 的余效应排序,且各自位置正是排序成立的原因。reload 在第 14 行提交已解析视图,unload 只在每个逆元运行后才丢弃它,因此只要纤程处于加载状态,包括其自身拆卸期间,它都读取同一组绑定。refresh 在第 10 行先把纤程标记为 UNLOADING,再创建转移任务;这是 L-Leave 步骤:纤程停止提供,其依赖方会先基于这一点重算,再有任何逆元被调度。unload 随后在第 25 行等待每个被通知依赖方到达 INACTIVE,这就是 L-Unload 的守卫。等待位于整个恢复之前,而不是位于正在被等待的某个逆元内部,因为 fiber.dispose 会并发启动一个纤程的效应;若把等待放在其中一个逆元内,其余逆元仍然无序。终止性来自定理 66:纤程只等待已停止满足的依赖方;若依赖方自身也是提供者,它会以同样方式等待自己的依赖方,因此提供者图按需遍历,而非预先分析。
5.1.4. 上下文访问
第 5.1.2 节的余效应操作构成反射式 API:用 ctx.set(key, value) 写余效应,用 ctx.get(key) 读余效应,二者都以名称为键。Cordis 在该反射 API 之上叠加第二种、更原生的扩展和消费上下文方式:属性访问。组件可以像访问上下文原生结构一样,通过属性 ctx[key] 访问余效应,而不是通过方法调用。在 TypeScript 中,Cordis 通过 Proxy 实现这一点,其 get trap 会中介每次属性访问。算法 6 展示上下文如何在第 5.1.2 节原语 get 之上把这种访问解析为余效应。
算法 6 Proxy 中介的上下文访问
1 function resolve(ctx, key)
2   fiber ← ctx.fiber
3   repeat
4     if key ∈ fiber.committed then return fiber.committed[key]
5     if key ∈ fiber.inject then throw INACTIVE_ACCESS
6     if fiber = root then throw UNDECLARED_ACCESS
7     fiber ← fiber.parent.fiber
算法 6 从访问上下文沿纤程链向上走:在第一个已提交视图绑定 key 的纤程处,访问获授权并返回该绑定;若行走到某个声明 key 但尚未提交它的纤程,则说明该纤程未加载,访问失败;若到达 root 而未见任何声明,则作为未声明访问拒绝。这正是 proxy 与裸 ctx.get 的不同之处:ctx.get(key) 是 store 查找,返回绑定值或空,且不会失败;proxy 则依据访问纤程自己的视图解析,并在使用点强制余效应规约 d。读取视图而非 store,也是定理 63 所依赖的内容,因为它让因依赖离开而触发拆卸的组件在拆卸期间仍能读取该依赖。
该拒绝是访问点上的运行时检查。由于组件的余效应规约 d 是静态声明的,原则上同一违规也可在编译期检测:在执行前把每个 ctx[key] 对照声明的 d 解析即可。第 6.4 节讨论宿主语言的类型级依赖声明和编译期元编程如何完成这种中介。
5.2. 组件加载器
核心库为组件开发者提供了动态组合的命令式原语,例如 ctx.effect、ctx.use 和 ctx.set。应用编排器则面对另一问题:它们把已有组件组装为运行系统,并在生命周期内调整组合。组件加载器通过引入声明式配置层处理这一问题:编排器将期望的组合作为持久数据结构指定,加载器把该规约的变化转换为相应的命令式纤程操作。
5.2.1. 声明式配置
第 4 节把运行系统分解为纤程,每个纤程都是某个组件实例。一次实例化所需的一切都可声明,因此编排器可以把整个系统描述为声明式配置:一条由加载器实现为纤程、并持续与纤程保持同步的持久记录。
**条目。**配置由条目组成。每个条目指定并管理一个纤程,绑定双向运行:加载器响应条目字段变化并调整纤程;组件若修改自身配置或禁用自身,变化也会写回条目。
定义 74. 一个条目声明单个纤程,并记录:
id:稳定标识符,在所属组的子列表变化时用作协调键;url:要实例化的组件模块 URL;isolate:应用于条目上下文的隔离注解;intercept:应用于条目上下文的拦截注解;config:绑定进组件以形成效应函数apply的配置;disabled:该条目是否被管理员关闭。
条目之所以能作为忠实规约,是因为支持纤程所需的信息恰由条目记录。定义 67 的支持集合只读取 τ,π,d,p;条目给出全部四项:disabled 给出 τ,配置树中的父条目给出 π,url 选择声明 d 与 p 的组件。支持集合不读取的字段是纤程运行时状态,而实例化同样不需要这些字段;在每个组件安装其声明的每个键时,引理 70 将支持集合与静止状态中的 Active 纤程对应起来。
这些条目形成配置树,是系统加载内容的权威记录。条目可以是映射到单个纤程的叶子;其组件也可以继续加载更多组件,使条目成为分支节点。Cordis 为这种分组与嵌套加载提供组件:@cordisjs/group 以子条目列表作为配置,并将其作为子组加载;@cordisjs/include 加载外部配置文件(YAML 或 JSON),并把条目嫁接为嵌套子树。二者都是基于定义 47 的注册原语(算法 4)的普通组件,因此嵌套树仍处于演算之内,后续结果适用于它。
**协调。**当条目记录变化时,加载器进行增量协调,而非整体拆卸并重建纤程。这样做的健全性来自元理论:
- 定理 73 使静止状态仅由最终配置决定:无论加载器途中执行怎样的实例化和退休、顺序如何,系统都会静止在从头加载最终配置所得到的位置。哪些组件最终被加载,只在每个组件安装其声明的每个键(定义 69)的前提下由声明读出;若某组件声明一个键但只在某些配置下安装它,加载器仍可协调该组件,只是最终加载集合也会受这些配置影响。
- 定理 66 证明系统确实会静止,因此在发出实例化和退休后,协调最终会完成。
- 推论 62 表明离开纤程对状态无净贡献,因此重建一个条目会撤回其纤程安装的内容,并保持周围纤程不变。
- 定理 63 允许条目一起实例化,无需编排器安排加载顺序:声明键尚未提供的纤程会在 L-Begin 等待,提供者离开的纤程会先于其提供者停用。依赖约束的是纤程何时激活,而不是模块何时获取和求值,因此加载器可以并发加载模块。
在条目声明的纤程之上,加载器依据发生变化的字段分派,并对每个字段采取最小扰动操作:
id,url:重建条目,因为身份或组件发生变化;isolate:重新分配条目 realm(算法 7);intercept:原地更新,因为拦截元数据在读取时查询,无需重载;config:交给组件,由组件决定如何应用新配置载荷,通常与旧配置做差异比较,仅在实质变化时重载。特别地,@cordisjs/group条目的config是其子条目列表,因此会以子id为键做差异比较,创建、移除或更新每个子项;由于更新幸存子项会重新进入同一字段分派,组协调和条目更新会沿树递归;disabled:设置时卸载纤程,清除时重新加载。
**受管 realm。**核心中的隔离通过在一个键上覆盖 realm 表 ρ 来派生子上下文(第 5.1.2 节),这在上下文树静止时足够。条目可能在运行时在组之间移动,所以加载器自行管理 realm;isolate 字段为每个键在两种作用域规则之间选择。值 true 表示局部 realm,私有于该条目并以其 id 标记,条目移动时随之移动;字符串值表示全局 realm,由所有命名该字符串的条目共享,因此移动此类条目会改变它与哪些条目共享绑定,而不是改变它所属 realm。若没有条目再命名某个 realm,该 realm 会被丢弃。
重新分配条目 realm 取决于哪些键改变 realm、条目自身是否为变化键上的提供者、以及要通知哪些依赖方。中间问题最难,因为一个 realm symbol 可被多个纤程共享,其中只有一个是提供者。加载器用定界符(delimiter)回答该问题:每个键有一个 symbol δ_k,每个上下文都在其下保存自己的标签。定界符写在上下文上并由后代继承,因此条目标签与提供者标签相同,当且仅当二者是在 k 的同一隔离作用域内派生出的;这正是 k 的绑定属于该条目自身并必须随其移动的情形。
算法 7 隔离 realm 重新分配
1 function patch_isolation(entry, ρ')
2   ρ ← entry.ctx[@@isolate]
3   store ← entry.ctx[@@store]
4   Δ ← {k | ρ(k) ≠ ρ'(k)}  ▷ realm 发生变化的键
5   for k in Δ do
6     entry.ctx[δ_k] ← fresh tag
7     diff[k] ← (ρ(k), ρ'(k), entry.ctx[δ_k], store[ρ(k)].fiber.ctx[δ_k])
8   entry.ctx[@@isolate] ← ρ'
9   reload(entry.fiber)
10  for k in Δ do
11    (s1,s2,d1,d2) ← diff[k]
12    if d1 = d2 and store[s1] and not store[s2] then  ▷ 该绑定属于该条目自身
13      store[s2] ← store[s1]
14      delete store[s1]
15  function affected(fiber, k)
16    (s1,s2,d1,d2) ← diff[k]
17    return fiber.ctx[@@isolate][k] ∈ {s1,s2} and (fiber.ctx[δ_k] = d1) ≠ (d2 = d1)
18  notify(entry.ctx, Δ, affected)  ▷ 取代算法 3 中的 realm 测试
该测试依赖定界符的一个性质。δ_k 下的标签写在条目上下文上,并由其派生的所有上下文继承,且每次重新分配都会新鲜抽取;因此对上下文 γ′ 有:
记该条件为 own(γ′),其中 d2 = d1 是提供者处的实例。重新分配会把满足 own 的上下文从 s1 移到 s2,其他上下文保持不变;上述循环在提供者满足 own 时才把绑定移到 s2。依赖方在其自身 k 上的 realm 与绑定所在 realm 相同时看见绑定。当依赖方与提供者的 own 一致时,二者同动或同不动,依赖方变更后看到绑定当且仅当变更前看到绑定;当 own 将二者分开时,一边移动另一边不动,依赖方获得或失去绑定。算法中的不等式正是这种分离,成员测试则丢弃那些在两个 realm 中都不解析 k 的依赖方。
5.2.2. 热模块替换
热模块替换(HMR)在模块层应用可逆效应模式:源文件发生变化时,通常在开发期间,系统不重启进程,而是原地替换受影响模块。由于纤程已经界定了其组件的全部效应与余效应,一个本身是组件的模块只需通过纤程操作即可替换:处置旧纤程会恢复该组件安装的一切;从重新加载模块实例化的新纤程会重新安装它。因此,相比 Webpack [46] 或 Vite [47] 的 HMR,Cordis HMR 不需要开发者标注接受边界。
@cordisjs/hmr 组件提供 HMR 引擎,分三阶段运行。
**阶段 1:模块分类。**引擎接收两个输入:stashed 集合(自上次重载以来内容发生变化的文件 URL)与 externals 集合(不能热替换、会触发完整重启的模块)。记 get_imports(url) 为 url 直接导入的模块,它会分类变化的依赖子图,把每个模块标记为 accepted 或 declined。
Algorithm 8 Module classification
1 function classify(stashed, externals)
2   accepted ← stashed
3   declined ← externals
4   pending ← ∅
5   for url in stashed do
6     pending ← pending ∪ (get_imports(url) ∖ (accepted ∪ declined))
7   repeat
8     progress ← false
9     for url in pending do
10      if get_imports(url) ∩ accepted ≠ ∅ then
11        accepted ← accepted ∪ {url}
12        pending ← pending ∖ {url}
13        progress ← true
14      else if get_imports(url) ⊆ declined then
15        declined ← declined ∪ {url}
16        pending ← pending ∖ {url}
17        progress ← true
18      else
19        pending ← pending ∪ (get_imports(url) ∖ (accepted ∪ declined))
20  until not progress
21  declined ← declined ∪ pending
22  return (accepted, declined)
该不动点以被 stashed 文件的导入为种子:一旦某模块的某个导入被接受,该模块即被接受;一旦其所有导入均被拒绝,该模块即被拒绝;仍未决且陷入导入环的模块默认拒绝。
**阶段 2:陈旧条目检测。**引擎用 accepted 与 declined 将组件条目过滤为陈旧条目,即依赖树到达已变化模块的条目。它用 get_dependencies 遍历每个条目的树,在收集某模块传递导入时把 declined 视为边界。
Algorithm 9 Stale-entry detection
1 function get_dependencies(root, declined)
2   deps ← ∅
3   function traverse(url)
4     if url ∈ deps or url ∈ declined then return
5     deps ← deps ∪ {url}
6     for child in get_imports(url) do traverse(child)
7   traverse(root)
8   return deps

9 function detect(entries, accepted, declined)
10  stale_entries ← ∅
11  for entry in entries do
12    tree ← get_dependencies(entry.url, declined)
13    if tree ∩ accepted ≠ ∅ then
14      accepted ← accepted ∪ tree
15      stale_entries ← stale_entries ∪ {entry}
16  return stale_entries
一个条目的依赖树与 accepted 相交,当且仅当该条目陈旧;随后该树会折入 accepted,使其中所有陈旧模块在下一阶段失效。
**阶段 3:事务式重载。**最后,引擎重载陈旧条目。它让 accepted 模块缓存失效3,并备份每个被移除模块以支持回滚;随后按 url 重新导入每个陈旧条目的组件模块,并替换为新纤程。
Algorithm 10 Transactional module reload
1 function reload(ctx, accepted, stale_entries)
2   backup ← invalidate_caches(accepted)
3   try
4     for entry in stale_entries do
5       entry.fiber.dispose()
6       entry.fiber ← ctx.use(import(entry.url), entry.config)
7   catch error
8     restore_caches(backup)
9     for entry in stale_entries do
10      entry.fiber.dispose()
11      entry.fiber ← ctx.use(backup[entry.url], entry.config)
12    throw error
事务保证系统不会进入半重载状态:若任意模块导入失败(例如存在语法错误),缓存会被恢复,每个陈旧条目都会从 backup[entry.url] 重新构建,即使用刚恢复缓存中的旧组件来撤销已经完成的替换。
3在 Node.js 中,这意味着同时清理 ES module 与 CommonJS 两套模块系统的缓存,因为通过 ES loader 导入的模块可能同时出现在二者中。
5.3. 案例研究:Koishi
Koishi 是构建在 Cordis 之上的开源聊天机器人应用框架4。经过四年多开发,它已积累超过 4000 个社区贡献插件5,覆盖即时通信(IM)适配器、数据库驱动、管理控制台和面向终端用户的功能等。其规模与多样性使它成为在生产场景中验证 Cordis 动态可组合性的代表性案例。
4Koishi 目前使用 Cordis v3。本文介绍 Cordis v4,它细化了效应与余效应语义并重新设计了加载器;二者共享核心组合模型。
5Koishi 使用术语 plugin 表示本文形式化为 component 的概念。
**元框架的表达能力与通用性。**Koishi 作为服务端机器人运行,其每个功能都实现为基于第 5.1 节上下文原语的插件;Koishi 自身只贡献聊天机器人领域词汇。同一模型也出现在完全不同的运行时中:Koishi Web 控制台是第二个独立 Cordis 应用,其插件组合的是浏览器和用户界面的原语,而非服务端原语。上述不同场景确立了第 3 节模型的两个性质:(1) 它具有表达能力:其原语足以承载完整生产系统,宿主框架只需提供领域词汇;(2) 它具有通用性:它固定效应和余效应如何组合,却把它们的含义留给各应用,因此既不预设特定领域,也不预设特定运行时。
**无认知开销的时间可组合性。**第 1.2.1 节调查的插件系统无法在不重启扩展宿主的情况下卸载单个扩展的效应。Koishi 经常执行这一操作:编排器在控制台禁用插件,其效应被原地撤回;开发期间,HMR 引擎在保存时重新应用已编辑插件,同时保留系统其他部分的缓存状态和活动连接。Cordis 让这种移除不仅可行,而且对插件作者而言几乎无负担。由于通过上下文执行的效应会被追踪,其逆元会自动组合(第 3.1 节),即便经验不足的作者也能为插件的上下文中介效应获得有序清理,而无须编写卸载路径。这实现了第 1.2.1 节指出缺失的关注点局部性:原本依赖每个作者谨慎程度的正确性,被抽象一次性承担。
**开放生态中的空间可组合性。**与第 1.2.1 节中插件间依赖基本缺席的插件系统相比,Koishi 生态呈现真实依赖拓扑:IM 适配器提供对各消息平台的访问,数据库驱动提供持久存储,功能插件则将这些声明为余效应并访问它们。运行时重新配置提供者,例如切换存储后端或重连适配器,只会重新激活那些解析到的依赖发生变化的依赖方(第 3.2 节);依赖不可用的插件会保持 inactive,直到依赖出现,而不会报错。该案例研究证实:这种组合能跨独立作者代码成立。插件及其依赖通常由不同作者编写,他们除了连接二者的余效应之外无需协调;反应式余效应因而能在开放独立贡献者生态中保持组装一致。
**有效性威胁。**这里的证据来自单一宿主语言中的单一生态,因此无法把范式本身的优点与其 TypeScript 实现或 Koishi 特定领域的优点分离;它也是观察性证据,而非与替代架构的受控比较。因此,该案例研究建立的是存在性与采用性结果,而非定量结果。衡量该抽象的开销,以及它相对基线对开发者生产力的影响,仍是未来工作。
6. 讨论
前文提出的形式模型与实现引入了一种动态可组合性的编程范式。本节考察该范式如何扩展到更广泛的工程问题,并讨论其中的设计张力与开放问题。
6.1. 系统边界
第 3.1 节中的每个效应都携带逆元,而该逆元究竟意味着什么由系统边界决定。边界把系统所面对的环境分成两部分。(1) 若系统能够独占地修改某个位置,并能恢复该修改之前的状态,则该位置位于边界内;其上的操作会在 中被追踪,并可稍后恢复。(2) 若任一能力不成立,则该位置位于边界外;其上的操作作为 ,因而既不被追踪也不被恢复。本节展开该边界的性质及其恢复后果。
**由余效应形成的边界。**余效应通过实体化外部位置来移动边界:它把对该位置的每次访问限制为自己提供的一组操作,而每个操作都能提供逆元。于是,原本作为 的操作开始在 中被追踪并恢复。因此,边界是按位置而非按介质划分的,因为上述两种能力是位置的性质;实体化改变的是访问位置的方式,而非位置所在介质。例如,某段内存只有系统写入时位于边界内,若其他进程也会写入则位于边界外;文件只有在系统独占可达时位于边界内,例如私有路径下的临时文件,若是其他程序也会读写的路径,则位于边界外。移动边界本身是一种取舍:环境是否为某位置提供可逆语义,以及在每次访问时提供这种语义的成本。第 6.7 节讨论这种取舍所提示的协同设计。
**获取与发射。**触及边界外部的操作通常分两阶段进行。(1) 获取阶段中,操作获得访问能力并在边界内安装一条记录:open 安装由 close 移除的描述符,malloc 保留由 free 释放的块,fork 启动由 kill 终止的子进程。该记录本身是实体化该位置的余效应的一部分,例如其维护的映射中的条目;安装该条目是可逆效应。同时,该记录也是数据离开的通道。(2) 发射阶段中,操作经该通道推出数据,例如 write 交给文件的字节,或 send 放到网络上的数据报;该推送作为 ,把数据留在其他参与方可读写的位置。两个阶段因此位于边界相反两侧:获取停留在边界内,而发射跨越边界。
**延迟与补偿。**若系统仍必须从发射中恢复,有两种方法。一是延迟发射,直到产生它的状态确定会持久存在;这就是 rollback-recovery 中的输出提交问题 [48]。二是补偿 [49]:执行一个动作,将状态恢复到应用提供的某种等价关系下,该关系比定义 33 的 ≃ 更粗,例如删除已创建文件或退还已收费交易。此类动作按与逆元相同的 LIFO 顺序组合,因此第 3.1 节的复合可转移到它们上。但元理论不会自动转移:定义 60 的交换性是在 ≃ 上证明的,必须针对更粗等价关系重新建立。
6.2. 服务复用
OSGi [50] 等动态组件平台围绕服务组织组合:服务是提供者在某接口下发布、消费者绑定的功能单元。Cordis 余效应模型呼应这一概念,其中服务对应于某个键背后的接口。提供服务的组件是其提供者,注入服务的组件是其消费者。单个服务可以由多个提供者实现,该多重性可通过两种形式实现:(1) 排他绑定:多个实现共享一个接口,但同一时间最多绑定一个;编排器选择绑定哪个实现,切换实现需要卸载一个提供者并加载另一个,会短暂扰动每个消费者依赖。(2) 服务代理(service broker):一个中央服务作为该接口入口,同时被后端提供者和消费者注入;多个提供者可共存,由代理在它们之间分派每个请求。相较排他绑定,代理吸收了这种扰动:更新后端提供者时代理保持不变,因此消费者看不到依赖变化,也不会触发重载。
服务代理支撑三项能力:负载均衡、滚动更新与跨进程调用。
**负载均衡。**多个提供者共存时,代理按可配置策略(例如轮询、最少负载、延迟加权)或消费者命名的显式目标在它们之间分发请求。由于提供者是普通组件,可通过添加或移除它们来扩缩容量;每个提供者通过可逆效应向代理注册,因此卸载它会自动撤销注册,并将其从代理路由集合中移除。
**滚动更新。**运行时升级服务实现可归约为受控提供者转移 [51, 52]。执行转移时,新提供者作为额外纤程加载并向代理注册;它进入 ACTIVE 后,流量逐渐从旧提供者转移到新提供者(例如通过调整选择权重),旧提供者在不再承载飞行中请求后卸载。这种提供者转移把传统基础设施层操作(例如容器编排、蓝绿部署)转化为应用层组合模式。
**跨进程调用。**服务代理也可跨进程边界应用 [53]。每个进程托管自己的 Cordis 上下文及本地提供者;一个协调组件将它们连接起来,把每个视为远程提供者。跨进程服务访问由保持接口的 RPC 机制中介,使分布对消费者透明。注意,跨进程调用会产生延迟并可能在飞行中失败,因此若以同步形式暴露会阻塞调用方。预期跨进程暴露的接口必须围绕异步契约设计。
6.3. 访问控制与沙箱
对于由独立组件组装的应用,安全需要两种互补机制:(1) 约束组件可访问哪些依赖;(2) 将不可信代码与宿主环境沙箱隔离。Cordis 通过依赖声明和拦截支持第一项;第二项需要外部沙箱。
**基于能力的访问控制。**依赖访问机制(第 5.1.4 节)已经构成一种对 proxy 中介属性的访问控制:组件只能访问自己声明的依赖;未声明访问会抛错。这在结构上类似基于能力的安全 [54–56],其中权限来自持有引用,而非环境权限。inject 声明充当能力请求,上下文 proxy 充当能力中介。由于这些请求是静态声明的,组件所需的 proxy 中介能力全集在运行前已知,编排器可在加载时审查并批准,而无需在访问发生时才发现。
这种中介可通过拦截机制推广到细粒度策略。访问控制元数据可由上下文携带或由组件声明(定义 30),提供者在依赖被调用时查询它,以决定是否允许请求。例如,文件系统依赖可携带声明组件可读写哪些路径的元数据,提供者逐次调用检查该元数据。由于这种拦截存在于上下文上,而不是任一方代码中,编排器可在不修改提供者的情况下调整它,以约束任意组件对依赖的访问,例如向社区组件授予只读数据库访问,而核心组件保留完整访问。此外,拦截只影响依赖如何被调用,不影响其是否满足,因此可在运行时安装、重配置或移除,而不触发重载或扰动依赖图。
**不可信组件沙箱。**当组件代码不可信时,语言级访问控制不足,因为可访问宿主运行时的恶意组件可直接触达底层对象,使检查失效。沙箱需要语言级手段无法越过的执行边界,例如软件故障隔离 [57]、独立语言运行时、沙箱进程或虚拟化容器 [58]。无论机制如何,不可信组件都在自己的沙箱上下文中运行,并通过桥接访问宿主提供的依赖。这是第 6.2 节跨进程调用的一般化:同样的透明性论证使桥接访问对组件而言不可区别于本地注入。在宿主侧,桥接是普通纤程,其能力可被上述访问控制衰减。
6.4. 语言独立性与选择
尽管 Cordis 以 TypeScript 实现,上下文范式与语言无关:时空可组合性只由两个可组合性维度定义,因此可在任何沿二者满足若干要求的语言中实现。我们分别分析两个维度的要求。
**时间可组合性。**最基本地,时间可组合性要求闭包:可逆效应把一个动作与一个逆元配对;逆元必须与其恢复的状态一起被捕获为值,以便拆卸时重放。除此之外,组件代码及加载它所产生的副作用必须能在运行时引入并撤回。
语言如何满足第二项要求取决于执行模型。在托管运行时中,这表现为程序化模块注册表:已加载模块可从注册表逐出,并在无引用后被垃圾回收;例如 Node.js 暴露了此类注册表。原生代码没有模块注册表,所以引入和撤回表现为显式动态链接与卸载(如 Unix 的 dlopen/dlclose、Windows 的 LoadLibrary/FreeLibrary [59]),即把目标代码加载进运行进程,随后分离它。WebAssembly 取哪条路径取决于嵌入器:在托管嵌入器(如 JavaScript 宿主)下,模块实例由宿主回收器回收;在原生嵌入器(如 Wasmtime)下,嵌入器丢弃实例时释放。跨这些机制,可逆效应模型都把加载视作上下文上的效应,其逆元撤销模块引入的符号、类型或处理器注册。
**空间可组合性。**空间可组合性要求组件能声明依赖,运行时能提供并注入这些依赖。这归约为依赖注入(DI)问题 [38],在不同语言中体现在两个层次:依赖如何类型化,以及访问如何被中介。
类型层面,语言应提供表达良类型依赖访问的方式。消费者通过从上下文读取键获得余效应,所以上下文类型(第 3.2.1 节)必须记录每个键的余效应。类型类(Haskell)[60] 与 trait(Rust)[61] 通过让提供者从自己的模块用 instance 或 impl 扩展上下文类型来实现这一点 [62]。TypeScript 的 module augmentation [63] 同样允许提供者模块把声明合并进上下文类型。
运行时层面,依赖访问必须被动态中介:键背后的余效应会随提供者加载/卸载而改变,也可能在不同上下文中解析不同。因此,语言需要透明地拦截访问,而不改变消费者代码,例如 JavaScript 的 Proxy 对象 [64] 或 Python 的 descriptor 协议 __get__ [65]。缺少此类原语时,运行时反射 [66, 67] 可动态中介访问,但代价是类型安全和开发者体验下降。
跨两个层次,元编程设施可同时提供类型和中介。注解 [68] 与装饰器将元数据附加到声明,由处理器展开为中介访问器;编译期元编程(如 Rust procedural macros、Scala macros [69]、Zig comptime)可为每个依赖生成类型化声明及其访问器,从而无需通用拦截原语。
6.5. 相互依赖与组件粒度
在反应式余效应模型中,依赖环会直接让相关组件永久 inactive:给定两个组件 A 与 B,若 A 需要 B 提供的键,B 又需要 A 提供的键,则二者的满足性谓词都无法为真。不同于并发系统中的死锁(其依赖调度,必须在发生时检测),这一条件可仅由依赖声明预测,因此运行时可在组件加载时报告。
实践中,大多数看似相互依赖的情形都可分解为更细粒度组件以消除环。考虑两个组件:服务器(提供网络接口)与访问控制器(强制授权策略)。二者双向交互:访问控制器中介到达服务器的请求,服务器暴露用于修改访问控制策略的端点。单体设计会让二者相互依赖。但两个交互方向是逻辑独立的关注点。分解后得到四个组件:server-core、access-control-core、request-mediation(依赖两个 core 以对入站请求应用访问控制)和 policy-management(依赖两个 core 以通过服务器暴露策略修改)。通过这种方式,环被消除,因为两个 core 互不依赖;只有集成组件同时依赖二者。
这种分解原则上总是可能的,因为每个双向交互都可分解为独立单向绑定,但它会增加组件数量:一般情况下,给定 n 个相互交互的组件,集成组件数量可能按 n² 增长,因为每对交互组件的每个方向都可能需要独立组件。这不影响正确性或运行时性能(组件很轻量),且更细粒度可能有益:用户可以只加载所需的特定集成绑定,从而提高系统可组合性。但它会影响开发者体验:更多组件意味着更多配置、更多命名,以及理解依赖图时的更多认知负担。
缓解这种粒度成本是工程问题,而非理论问题。实践策略包括包捆绑(将相关细粒度组件打包为单个可安装单元)、约定式连线(自动连接名称或类型匹配某种模式的组件)和脚手架工具(从声明式规约生成样板集成组件)。这些策略在保留无环模型形式保证的同时,将作者负担降到接近单体情形。
6.6. 依赖类型与版本
在形式模型中,依赖链接完全由键身份建立:提供键 k 的组件满足任何在依赖集合中声明 k 的组件。类型族 V_k 保证单个编译单元内的类型级一致,但当组件独立开发和构建时,该保证会失效,而这是组件生态中的常见场景。这导致两个不同问题。
**接口漂移。**提供者可能在版本间修改与 k 关联的接口(添加字段、改变方法签名、修改行为契约),而基于早期接口编译的消费者仍声明同一键 k。依赖在余效应层面得到满足(k ∈ dom(σ)),但运行时值不再符合消费者期望,导致类型错误、方法不存在失败或隐蔽行为偏离 [70]。
**键冲突。**两个独立开发的提供者可能用同一键名 k 表示完全无关的接口。由于仅由键身份建立链接,期望某个提供者接口的消费者会接受另一个提供者的值,而没有任何兼容性检查。不同于接口漂移(提供者和消费者至少共享共同谱系),键冲突在期望类型与实际类型之间没有任何关系,使失败不可预测且难以诊断。
两个问题指向同一缺口:余效应模型只提供名义链接(按键名),而没有版本化或结构化链接(按接口兼容性)[71]。本文讨论三种处理路径,从最依赖基础设施到最语言无关。
**键命名空间化。**将键空间从 K 扩展为 K × P,其中 P 标识定义接口的包,可从构造上消除键冲突:独立开发的同名接口占据不同键。这是最直接方案,但也耦合最强:它把包命名空间嵌入形式模型本身,使系统依赖外部包注册表来确定键身份。
**Peer dependencies。**较轻的耦合是通过宿主语言包管理器声明版本约束 [72]。Cordis 当前采用该方法。组件依赖在语义上是 peer dependency:组件不会把依赖内部捆绑,而是期望运行时上下文提供它们。支持 peer dependency 的包管理器(如 npm)可强制版本兼容:若提供键的包版本落在消费者声明的 peer 范围之外,不兼容会在安装时被捕获,而不是表现为运行时失败。但该方法有两个限制:(1) 它依赖提供者忠实遵守语义化版本,这是无法强制的约定;(2) 包管理器通常把每个依赖解析到单一版本,这阻止在一个应用内加载同一包多个版本的组件。
**结构兼容。**完全语言无关的方法会把成员检查 k ∈ dom(σ) 替换为兼容性谓词,验证提供者实际接口在结构上涵盖消费者期望。这类似结构子类型 [73]:若提供接口是所需接口的子类型,则提供者满足消费者。挑战在于以语言无关方式定义该谓词:对记录类型(宽度子类型)而言结构兼容很直接;但遇到行为契约(如前/后置条件 [74]、效应规约 [22])时会变复杂;一旦参数多态引入有界量化 [75],该问题不可判定。
三种方法处理问题的不同方面。设计一种统一依赖模型,在保留余效应模型动态组合保证的同时结合这些方法,仍是开放问题。
6.7. 与语言和操作系统协同设计
第 6.4 节识别了宿主语言支持上下文范式所需的最低能力。本节转而讨论反向问题:与该范式协同设计的语言或操作系统还能提供什么超出最低要求的能力。
**与语言协同设计。**围绕上下文范式设计的语言可在两个方面优于库:为上下文赋予的语义,以及为效应和余效应提供的原语。
这样的语言可以在保持第 3.3 节上下文语义的同时,再次把上下文隐式化。命令式语言已经让每条语句在隐式上下文中运行,但这个单一上下文既不追踪效应也不解析余效应。上下文范式则区分多个上下文,其中一个操作要么修改其运行所在上下文,要么由其派生另一个上下文(定义 27)。原地实现像命令式语言一样修改环境上下文;派生实现则引入独立上下文,语言需为此提供构造。隐式上下文带来易用性和安全性收益:(1) 在库实现中,所有涉及效应或余效应的函数都必须把上下文作为普通参数或接收者,如第 5.1 节所示;语言隐式提供上下文时,函数不再需要接收它。(2) 每个上下文都携带自身生命周期状态与已提交视图(第 4.1 节)。库实现把上下文作为普通变量传递,所以组件可能通过闭包或全局变量误触另一个组件的上下文;在那里安装的效应会泄漏出自身生命周期,读取的余效应则会逃离依赖规约。隐式上下文可关闭这两类漏洞。
这样的语言也可让编译器知晓效应与余效应。(1) 对效应,效应迭代器(定义 51)在每步分配闭包,用以保存逆元及其恢复状态。若语言有执行效应的语法,编译器可为整个迭代生成单一状态机,并在其栈帧中持有这些逆元。(2) 对余效应,余效应规约可进入类型系统,带来两项收益。第一,依赖环可在编译期报告,而无需留给运行时(第 6.5 节)。第二,依赖可按其类型结构比较,而非仅按键身份比较,正如行类型所做的那样 [28];这是第 6.6 节结构兼容性的类型级支持。
**与操作系统协同设计。**第 1.2.3 节指出了动态可组合性的粗粒度替代方案:操作系统在进程粒度提供时间可组合性,其上的容器编排器在服务粒度提供空间可组合性。与该范式协同设计的操作系统可支持细粒度组合:把组件声明的余效应规约作为它能触及的全部内容,并把自身资源作为余效应提供。
这样的操作系统可提供第 6.3 节推给语言外机制的沙箱。它通过将组件约束在其声明的依赖范围内来实现:组件加载时供应这些依赖,并让组件内部不可达其他内容,正如 WebAssembly 模块在实例化时从嵌入器接收导入 [76]。它也可把第 3.2.3 节的余效应隔离与拦截作为自身能力,为每个组件不同地绑定键,并中介其供应的访问。
这样的操作系统还可把自身资源作为余效应提供。若运行时记录每次获取并把它归因于发起该获取的组件,则边界外资源可被做成可逆(第 6.1 节);每个运行时本来都会保存自身记录。若操作系统把资源作为余效应提供,该记录只需由它保存一次,因为它正是分发资源的一方,也能把资源归因于请求组件。内存和文件描述符是直接候选;为恢复而追踪它们已在内核接口层实现过 [77, 78]。此外,操作系统还可让第 6.1 节只能延迟或补偿的部分操作变得可逆。以事务方式写持久存储的系统可回滚写入 [79];建立在写时复制或不可变存储之上的系统可通过移动指针回到早前状态 [80, 81]。
7. 相关工作
动态可组合性与多个既有研究领域相交。本文概述最相关的工作线索,并区分我们的贡献与各自的差异。
7.1. 效应与余效应系统
第 2 节回顾了作为本文理论支柱的效应与余效应。这里先定位工业实践中常见的单子效应系统,再概述三条与 Cordis 相关的研究线索:将代数效应重述为能力、为效应赋予可逆语义,以及在单一分级纪律下统一效应与余效应。
**单子效应系统。**一类库在既有通用语言类型系统中编码效应,把它们表示为由运行时执行的单子值。Scala 中的 ZIO [82] 将计算建模为 ZIO[R,E,A],TypeScript 中的 Effect-TS [83] 建模为 Effect<A,E,R>;泛型参数描述结果、类型化错误以及上下文必须提供的服务。fp-ts [84] 则通过基于 Reader 的单子变换器编码相同的错误与需求通道。两点将这些系统与 Cordis 区分开。第一,追踪依赖单子嵌入:程序只有写在效应类型内部才能获得它;Cordis 则把效应追踪作为普通宿主代码上的覆盖层。第二,需求通过解释来消解,即由已安装服务提供操作;当该服务被撤回时,其操作已经执行的内容会留在原处。Cordis 则把每个效应与逆元配对,并在提供者出现和消失时重新解析需求(第 3.1、3.2 节)。
**作为能力的代数效应。**代数效应(第 2.1 节)让效应操作对类型系统可见。与本文最接近的扩展是 Brachthäuser 等人的 Effekt 语言 [85, 86],它把效应类型重新解释为能力:效应类型表达计算从上下文需要什么,而不是可能产生什么副作用。这一视角与本文一样把上下文视为能力中介。Cordis 与 Effekt 有两点不同:(1) 目的不同:代数效应让效应可见是为了支持模块化解释,为同一操作提供多种处理器语义;Cordis 让其可见是为了支持追踪和回滚,把每个上下文变换与逆元配对。(2) 场景不同:Effekt 在类型层静态约束效应,默认使用基于作用域的推理,其中能力是二等的、受限于词法作用域;它通过 boxing 恢复一等使用,并在类型中追踪捕获能力。Cordis 则在运行时约束效应,目标是在组件移除时完整恢复资源;第 6.7 节讨论了语言若在这一意义上让上下文成为二等实体,可额外提供什么。
**可逆效应语义。**另一条平行工作线索为效应赋予可逆语义,而非解释语义。Heunen 等人 [87] 通过把 Hughes 的 arrows 改造为 dagger arrows 与 inverse arrows,在可逆设置中建模副作用,捕获序列化和可变存储等操作带有逆元的效应。这是与本文可逆效应最接近的形式化描述:二者都把效应与撤销手段配对,而不是通过 handler 消解。差异在于可逆性存在的位置和所要求的强度。Heunen 等人在指称式范畴语境中工作,其中可逆性是全局性质,由构造保证,因为每个计算都可逆,且逆是双侧的并由范畴结构恢复。Cordis 在运行时追踪逆元,要求更弱:不要求整个计算可逆,只要求每个原子效应具备一侧逆元,由调用者在施加点提供,而非被推导;任意复合的逆元再由复合得到(第 3.1 节)。
**作为统一效应与余效应的分级类型。**Orchard 等人 [88] 提出分级模态类型,作为同时涵盖效应推理(通过分级单子)与余效应推理(通过分级余单子)的总括概念,并在 Granule 语言中实现,展示单一类型系统可同时追踪计算做什么与需要什么;近年工作还把余效应扩展到命令式 Java-like 语言 [89, 90] 与 call-by-push-value [91]。这些工作都位于类型层:效应与余效应是编译期在词法固定作用域上检查的静态标注。本文贡献与这种分析正交:我们将同两种概念提升为运行时机制,使 Cordis 能处理动态组合。时间撤回与空间依赖会随着已加载组件集合演化而重新解析,而非在固定程序文本上一次性决定。
7.2. 编程范式
第 3.3.3 节把上下文范式确立为一种通过显式上下文中介效应和余效应的纪律。两个既有范式值得显式比较:一个共享术语,另一个共享对横切关注点的处理。
**面向上下文编程。**COP [92, 93] 为语言配备 layer,即可在运行时依据执行上下文激活和停用的部分方法/类定义,使行为适配而无需基础代码命名其上下文依赖 [94]。COP 与 Cordis 都把上下文视为一等、运行时可变实体,也都动态激活和停用行为,但相似性主要是名义上的。在 COP 中,“上下文”表示环境执行情境(位置、用户、模式等),激活会在动态作用域范围内改变方法分派;layer 既不追踪其诱发的副作用,也不回滚它们,激活也不由依赖满足性控制。在 Cordis 中,上下文是中介效应与余效应的 实体:激活运行组件的可逆效应,并由反应式余效应满足性驱动(第 3.2 节);停用则完整回滚这些效应。COP 改变运行什么行为;Cordis 组合并回滚组件安装的效应和依赖。二者差异体现为取舍:COP 将激活折入宿主语言方法分派,获得动态作用域 layer 范围,但依赖特定语言;Cordis 作为语言无关覆盖层,在共享上下文上反应式解析激活。因此,Cordis 只能把 COP 的全局、值驱动片段表达为余效应:即实现之间的上下文相关选择,而不能表达动态作用域激活。
**面向切面编程。**AOP [95, 96] 将横切关注点模块化为 aspect:pointcut 量化基础程序中选定 join point,advice 被织入其中。Cordis 处理的是同一类上下文行为问题,否则这些行为会散布于组件;但其 aspect 类比物是余效应:许多组件声明依赖的共享中介点,横切行为可在那里重塑而无需编辑组件。两种范式在两轴上不同。(1) 声明性与不知情性:AOP pointcut 是不知情且量化的,匹配代码本身不知道被增强的任意 join point;Cordis 则把横切限制在每个组件声明的余效应上,因此其覆盖范围恰是声明表面。这带来确定性和可追踪性:应用编排器可在配置层检查和治理哪些内容横切某组件,而无需阅读或分析源码;AOP 关注点则只能通过量化它的 aspect 来理解。(2) 生命周期集成:Cordis 中的横切变化由组件效应承载,随组件卸载回滚,并反应式传播给依赖方,因此是动态组合模型中的一次移动;dynamic-AOP 系统 [97, 98] 也可在运行时 weave/unweave,但作为独立操作,不绑定组件生命周期,也不会触发被增强代码间的重新解析。
7.3. 时间可组合性
时间可组合性关注在运行程序中替换或移除组件,同时恢复其安装的效应。既有方法可按如何处理离开组件的状态与效应划分:把状态前向迁移到后继版本;通过开发者编写的清理恢复效应;在预先固定的作用域中自动逆转效应;或在运行时控制的接口上拦截并积累记录,从而回收资源。
**有状态前向迁移。**一大类系统通过在版本间前向携带状态,在不停机情况下替换运行程序中的组件。它们遵循同一时机纪律:组件只能在到达安全、无交互点后被替换。Kramer 与 Magee 将该准则确立为 quiescence [51],Vandewoude 等人后来将其放宽为干扰更小的 tranquility [52];本文的滚动更新模式(第 6.2 节)通过在卸载提供者前排空飞行中请求来强制该准则。动态软件更新(DSU)随后通过手写转换函数迁移状态:Hicks 等人的通用 C DSU [99]、Stoyle 等人基于 con-freeness 分析的类型安全更新点 [100]、Hayden 等人的 Kitsune [101] 都把旧版本数据映射到新版本表示,原地继承堆对象、打开文件和连接,同时重新初始化未迁移内容。同一纪律也扩展到持久状态:Overeem 等人 [102] 通过手写升级操作在 schema 版本间转换运行事件存储数据并保持系统可用。Erlang/OTP [15] 在进程层采取同一立场,通过 code_change/3 迁移状态,并通过重启受监督进程而非回滚其效应来从故障恢复;JavaScript HMR(如 webpack [46]、Vite [47])在模块层同样通过 module.hot 或 import.meta.hot API 在 reload 之间前向交接状态。相较 Cordis 模块替换(第 5.2 节),这些方法更优雅地迁移内存状态:Cordis 回滚旧组件的被追踪效应,并从干净状态重新施加新组件效应,所以组件自身内存状态不会在 reload 后保留,除非放入寿命更长的依赖中;在可逆效应上叠加 DSU 式前向迁移是未来工作。尽管如此,Cordis 在两方面更通用:它不需要 DSU 与 HMR 所需的手写迁移函数,并支持完全卸载组件和恢复其资源,而不仅是原地更新组件。
**开发者编写的恢复。**第二类方法通过开发者手写的清理或补偿逻辑恢复组件效应。插件生命周期惯例(如 OSGi [50]、Eclipse extension points、IntelliJ 和 VSCode)把清理委托给开发者编写的卸载回调;Command pattern [103] 把操作与 undo 方法封装在一起以支持撤销/重做栈;saga 模型 [49] 把长事务构造为一系列步骤,每步配对补偿动作;代数效应处理器可附加在拆卸时运行的 finalizer [104];event sourcing [105] 则通过追加补偿事件而非执行逆元来撤回状态。它们都把逆元作为未被强制的义务,与操作解耦;忘记逆元就会悄然泄漏资源。React 的 useEffect 钩子 [106] 最接近结构化地配对效应与逆元:返回一个 cleanup,由运行时在每次重执行前和 unmount 时调用。其不足在于可组合性:hook 只能在组件或另一 hook 顶层调用,不能位于条件、循环或嵌套函数中;其 effect body 既不能是 async 函数,也不能是 iterator。因此,效应不能由其他效应组装,也不能与控制流交错,更没有可据以导出复合逆元的内容。Cordis 效应没有这些限制:它们是可自由组合、可异步运行的普通操作;只需为每个原子效应手写逆元,任意复合的逆元由复合导出。因此,组装既有效应不需要再写逆元。每个效应与其逆元的结构性配对,使完整恢复成为系统不变量,而非开发者纪律。
**静态作用域逆转。**第三类方法以构造方式自动逆转效应,但将逆转限制在预先固定作用域中。软件事务内存 [107,108] 源自硬件事务内存 [109],记录读写日志,使一组内存操作要么提交、要么中止并把内存回滚到事务前状态。可逆计算从 Landauer 与 Bennett 的热力学分析 [110,111] 到 Janus 等可逆语言 [112] 更进一步,让整个计算的每一步都全局可逆。可逆进程演算则把回溯构建进语义:RCCS [113] 为每个进程携带记忆,并允许在其所导致的过去因果等价时撤回一步;Phillips 与 Ulidowski [114] 统一导出 CCS、ACP 和 CSP 的可逆算子,同时保持其前向操作语义。其因果一致性准则是 Cordis 恢复顺序的并发对应物:累加器按 LIFO 顺序施加组件自身逆元,第 4.3.1 节的守卫则把提供者撤回推迟到消费者停用之后(定理 63)。但其覆盖范围由语义固定,每个已执行动作都保持可撤销;Cordis 组件则为每个原子效应提供逆元,累加器把上下文带回其组合开始处。线性类型 [115]、RAII [4] 和 Rust 所有权系统 [61] 将资源释放绑定到词法区域。它们都静态固定逆转作用域与范围;Cordis 不预先固定此类作用域,而是在组件生命周期上回滚任意上下文操作,并把词法资源管理视为互补机制,适合单个组件内部的局部资源。
**拦截式回收。**第四类方法不要求组件自身提供逆元,而是在运行时控制的接口上记录其获取内容,并据此回收。Nooks [77] 包装 Linux 内核与可加载扩展之间边界上的每次调用,使扩展触及的内核对象经过对象追踪器;追踪记录告诉恢复管理器扩展失败时释放什么。shadow drivers [78] 从另一侧拦截同样调用,记录决定驱动状态的请求和配置,使重启实例可恢复到该状态。Akeso [116] 则通过编译器插桩获得记录,把内核执行划分为可嵌套恢复域,记录状态变化和跨线程依赖,并把出错请求及其依赖域一起回滚。这类方法的回收来自运行时维护的记录,而非开发者记得编写的 cleanup,因此是可逆效应最接近的系统级先例。其与 Cordis 的差异在词汇和覆盖范围上。平台固定什么可被记录:每种内核对象类型的释放代码、每类驱动一个 shadow,或每个被插桩分配器一个逆元;组件只能持有平台已经知道如何释放的资源。Cordis 组件则可引入自己的效应,并为每个原子效应提供逆元(第 3.1 节)。回收范围也受限于一次提交请求或同一扩展重启;Cordis 则覆盖组件整个生命周期,并把移除传播给依赖方,依赖方再依次释放自身效应(第 3.2 节)。
7.4. 空间可组合性
空间可组合性关注组件对其他组件的依赖如何声明和绑定。既有机制可按绑定如何响应变化划分:初始化时一次性连线依赖;响应整个组件可用性;或在单个值粒度上传播变化。
**初始化时依赖连线。**两类既有机制在初始化时把组件连线在一起。依赖注入框架 [38](如 Spring [117]、Guice、Angular、Inversify)在初始化时向组件注入依赖;UI 框架上下文(如 Vue.js 的 provide/inject 与 React Context API)沿组件树传递依赖。一些机制支持动态作用域(如 Spring prototype/request scopes、Angular hierarchical injectors),但二者都不会反应式重新解析:提供者运行时被替换或移除后,已有依赖方不会被停用或重新初始化,也没有本文组件状态机所提供的生命周期管理。Cordis 的反应式余效应(第 3.2 节)提供了这一点:每当满足性谓词改变,通知机制都会触发生命周期转移。
**可用性反应式组件模型。**与本文反应式余效应最接近的先例,会响应服务可用性。OSGi Declarative Services 与 iPOJO [118,119] 允许组件声明提供和需要的服务,运行时会在服务出现和消失时自动激活/停用组件;iPOJO 的 Gravity 项目 [119] 明确面向随服务可用性变化而自主运行时适配,其 provide/require 模型直接预示了 Cordis 的 ctx.provide/ctx.get 模式。R-OSGi [53] 通过 RPC 将同一抽象透明扩展到分布式场景,把网络故障映射为服务撤回事件;第 6.2 节把这种模式作为 Cordis 模型的扩展讨论。这些系统都通过停用回调恢复,而这有两个限制。第一,回调是手写的,资源安全依赖开发者纪律,遗漏会悄然泄漏。第二,回调是同步的;若拆卸需要与即将离开的依赖进行异步交换,框架没有协议等待它,只能对可能已经陈旧的引用做阻塞等待。Cordis 的反应式余效应弥合两处缺口:停用会回滚依赖方累积的效应,其惯性 Unloading 状态(第 4.3.3 节)会在响应进一步变化前把异步拆卸运行到完成。
**值级反应性。**函数式反应式编程(FRP)[120] 及其现代形态(如 SolidJS 中的 signals [121,122]、Vue reactivity system、Angular Signals)在值级粒度上传播变化:signal 变化时,派生计算会同步或在调度器下重新求值 [123]。Cordis 的反应式余效应在组件级粒度上运作,添加值级传播不建模的异步生命周期语义。粒度差异在一致性方面也反向体现:在由依赖图确定的顺序中于一个 turn 内传播,使 FRP 能要求没有派生计算读取新旧输入混合,即 glitch freedom [124];Cordis 没有 turn 的对应物,编排动作逐个到达,只保证单个转移不会跨越两种余效应解析(定理 64)。二者互补而非竞争:Cordis 余效应本身可以携带反应式值,组件只根据实际消费部分更新,从而把组件级反应性细化为跨两个层次的更细粒度反应式余效应。
8. 结论
本文通过将经典的效应与余效应概念提升为运行时机制,为动态可组合性提供了形式基础。可逆效应处理局部时间可组合性:每个上下文变换都携带运行时追踪的逆元,追踪和恢复均保持组合性,因此组件移除时可恢复上下文。反应式余效应处理局部空间可组合性:上下文每次变化时,组件都会依据其余效应规约被通知,每次变化被分类为激活、停用或中性;余效应隔离改变声明键解析到什么,余效应拦截改变绑定如何被使用。我们将效应上下文与余效应上下文统一为单一上下文类型;其中,余效应上的观测等价关系为效应提供独立性,从而构成面向时空可组合性的编程范式。将这些机制结合为组件概念后,可得到动态组合演算;其元理论把时空可组合性从单个组件推广到交错组件构成的整个系统。我们把该范式实现为 Cordis 元框架:其核心库提供效应追踪和余效应解析,声明式组件加载器提供配置协调与热模块替换。Koishi 案例研究在拥有 4000 多个社区插件的生产系统中验证了 Cordis 设计。
除人工维护的插件生态外,一个有吸引力的未来验证方向是可自我演化的智能体运行框架(第 1.2.2 节):AI 智能体会以很少人工监督持续生成和替换自身运行框架组件。在这样的环境中应用 Cordis,可验证其在快速组件替换下完整恢复的时间保证,以及在频繁拓扑变化下依赖协调的空间保证。这类验证将展示该范式作为智能体运行框架和其他自治系统中可恢复、可协调、连续自我演化基础的适用性。
参考文献
参考文献条目保持原文英文书目信息,未在本译稿中重排或改写;请以原 PDF 的 References 部分为准。
译者说明
感谢原作者对时空可组合性、可逆效应和反应式余效应相关问题的研究。
本文仅作为中文阅读材料,不替代原论文。译文中的术语、公式或排版如有疏漏,请以原文为准,也欢迎提交反馈或修正建议。
论文版权及许可信息归原作者和原项目所有。转载或二次发布时,请保留原文来源、作者信息和本译者声明。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!